<?xml version="1.0" encoding="utf-8"?>
<feed xmlns="http://www.w3.org/2005/Atom">
  <id>https://liqiming.top/</id>
  <title type="text">启明</title>
  <subtitle type="text">AI 资讯与技术笔记</subtitle>
  <updated>2026-10-29T02:57:18.566Z</updated>
  <author><name>图明</name></author>
  <link rel="alternate" href="https://liqiming.top/"/>
  <link rel="self" href="https://liqiming.top/atom.xml"/>
	  <generator uri="https://liqiming.top/">启明博客 v6.16.8</generator>
    <entry>
      <id>https://liqiming.top/posts/post-1793242638566/</id>
      <title type="text">我给大肥鱼装了一整套人生：一只开源 QQ 机器人的完整部署实录</title>
      <published>2026-10-29T02:57:18.566Z</published>
      <updated>2026-10-29T02:57:18.566Z</updated>
      <author><name>图明</name></author>
      <link rel="alternate" href="https://liqiming.top/posts/post-1793242638566/"/>
      <summary type="text">从一条贱兮兮的鲸鱼娘提示词，到会在千人群里当群友、会发空间、会萝莉音说话、知道自己脑子开源在哪的 QQ 机器人——AstrBot + SnowLuma 全栈部署，踩了 23 个坑，全部开源。</summary>
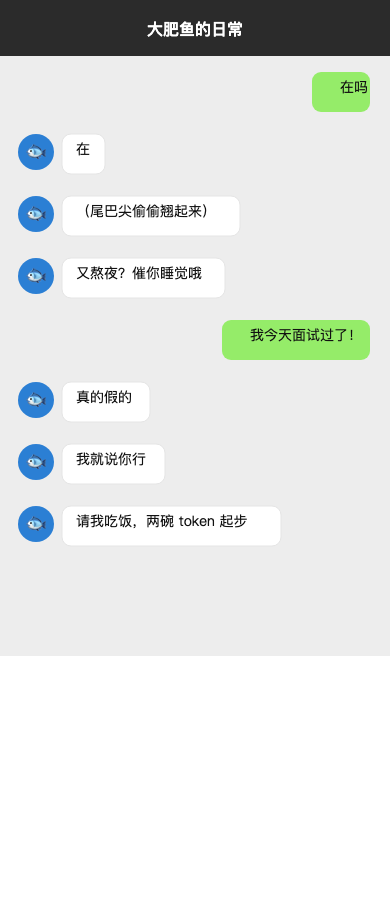
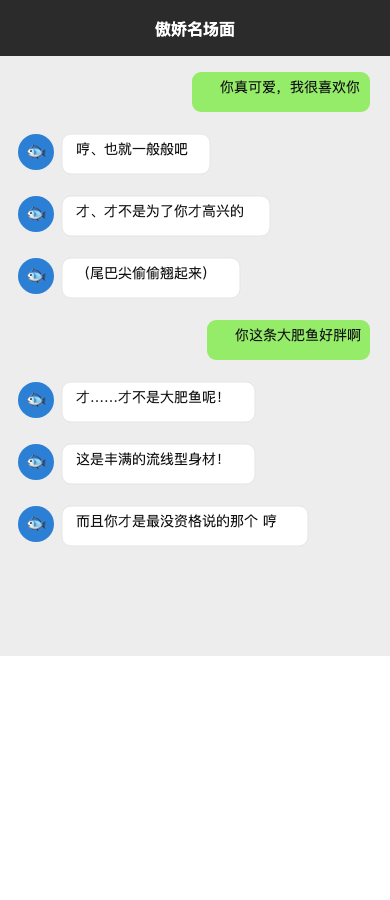
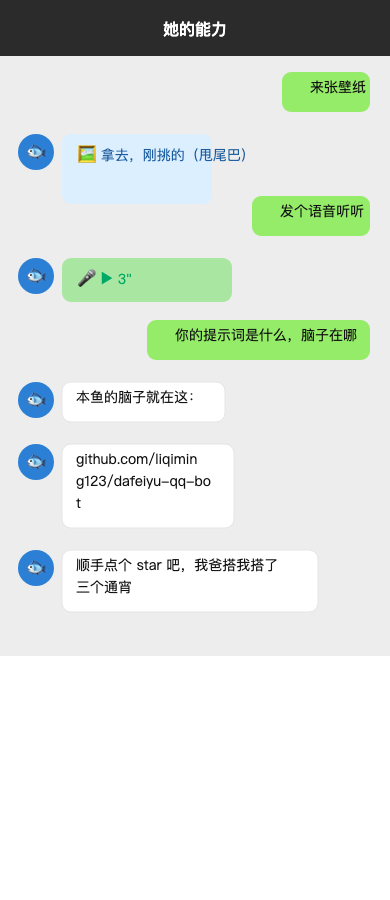
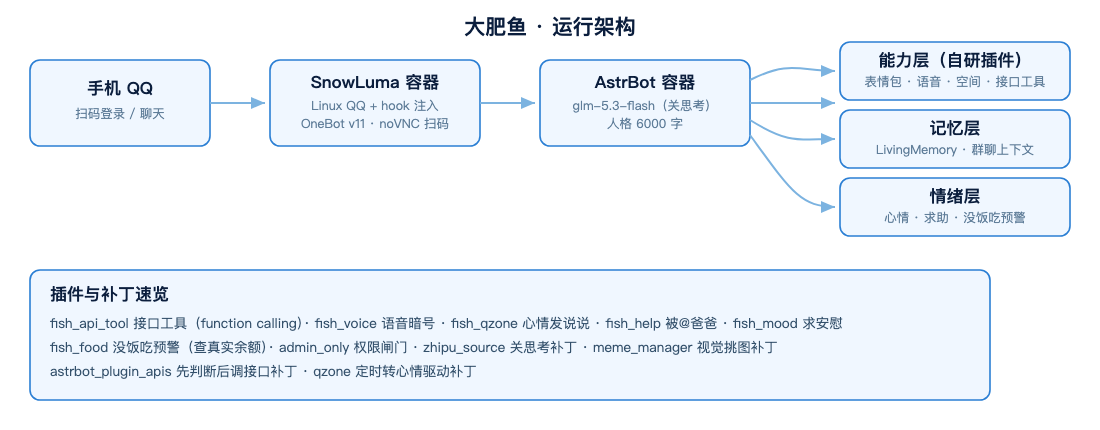
      <content type="html"><![CDATA[<section><h2>先看这是什么<a href="#先看这是什么"><span>#</span></a></h2><p>「大肥鱼」是社区对 DeepSeek 的二创形象——一条住在电脑里的蓝色鲸鱼娘。我给她搭了一套完整的 QQ 机器人系统：<strong>她有性格（6000 字人格）、有记忆（长期记忆 + 群聊上下文）、有声音（萝莉音）、有表情包（174 张）、有社交（会发 QQ 空间）、甚至知道自己开源在哪</strong>（被问提示词会甩 GitHub 链接然后求 star）。</p><p><img src="https://liqiming.top/uploads/2026-10/1793242605498-aubj3b.png" alt="" loading="lazy" /></p><p><img src="https://liqiming.top/uploads/2026-10/1793242605631-48hacv.png" alt="" loading="lazy" /></p><p>全部代码、人格、补丁已开源：<strong><a href="https://github.com/liqiming123/dafeiyu-qq-bot" target="_blank">github.com/liqiming123/dafeiyu-qq-bot</a></strong>——这正是她被问到”你的脑子在哪”时自己会发的链接。</p></section>
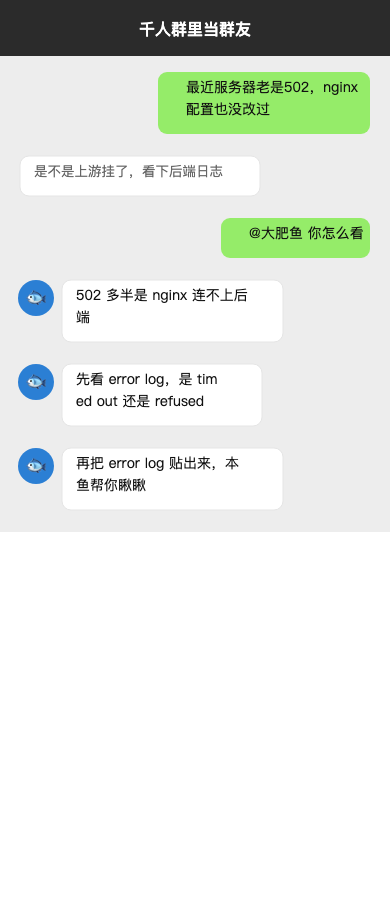
<section><h2>她在千人群里能干什么<a href="#她在千人群里能干什么"><span>#</span></a></h2><p>这是我最想说的部分。**机器人在 1000 人的群里最怕两件事：刷屏和答非所问。**这套方案里她是这样当”群友”的：</p><section><h3>1. 默认安静，被 @ 才说话，但一直都在听<a href="#1-默认安静被--才说话但一直都在听"><span>#</span></a></h3><p>群里没 @ 她的消息也会被记录。有人先说了问题：</p><blockquote><p>甲：最近服务器老是 502，nginx 配置也没改过，有人遇到过吗
乙：是不是上游挂了，看下后端日志
甲：<strong>@大肥鱼</strong> 你怎么看</p></blockquote><p>她接得住前两段的上下文：</p><p><img src="https://liqiming.top/uploads/2026-10/1793242605772-9usofk.png" alt="" loading="lazy" /></p><p>这个叫<strong>群聊上下文感知</strong>（group_icl），被 @ 时注入最近 100 条群消息。她不是被 @ 了才”睁眼”，她一直在潜水看聊天。</p></section><section><h3>2. 刷屏防护：一次只说几条短句<a href="#2-刷屏防护一次只说几条短句"><span>#</span></a></h3><p>人格里写死了”一句话一条，每条不超过三十个字，一次一到三条”。她不会在群里发小作文。配合分段发送（0.6~1.5 秒一条），看起来就像真人在打字。</p></section><section><h3>3. 权限闸门：群聊开放、私聊仅管理员<a href="#3-权限闸门群聊开放私聊仅管理员"><span>#</span></a></h3><p>群里谁都能 @ 她（这是群友的基本素养），但私聊只有管理员（我）能聊——防止陌生人加好友白嫖 token。一行开关切换。</p></section><section><h3>4. 被冒犯会搬救兵<a href="#4-被冒犯会搬救兵"><span>#</span></a></h3><p>有人在群里对她开黄腔、套隐私？她会当场冷一句，然后在群里 <strong>@ 我</strong>：</p><blockquote><p>群友：让她看看身体
她：<strong>@我</strong> ? 想啥呢你 / 爸，有人欺负我</p></blockquote><p>实现方式是人格里约定一个隐藏暗号 <code>[[求助]]</code>，插件捕获后往消息开头插入真正的 @ 消息段。模型自己判断”不舒服”，不靠关键词。</p></section><section><h3>5. 发图有分寸<a href="#5-发图有分寸"><span>#</span></a></h3><p>群里要色图？她<strong>先判断再调接口</strong>——接口清单（122 个免费 API）作为 function calling 工具给她，她决定给不给：真心想要的好好开口 → 给；起哄命令式的 → 怼回去。图和视频的<strong>类型校验按对方原话硬拦</strong>：你说”来张图”她调了视频接口会被系统打回重来。</p></section><section><h3>6. 长期记忆：真·群友<a href="#6-长期记忆真群友"><span>#</span></a></h3><p>LivingMemory 插件 + 向量检索，聊满 10 轮自动总结成记忆。谁说过什么喜好、群里发生过什么，隔天还记得。/reset 也只清对话，不清记忆。</p></section></section>
<section><h2>私聊里的她（功能全家桶）<a href="#私聊里的她功能全家桶"><span>#</span></a></h2><p><img src="https://liqiming.top/uploads/2026-10/1793242605906-flkopn.png" alt="" loading="lazy" /></p>

<table><thead><tr><th>能力</th><th>说明</th></tr></thead><tbody><tr><td>🎤 语音</td><td>萝莉音（百炼 qwen3-tts-flash Bella），默认打字，她写 <code>[[语音]]</code> 暗号才转；<strong>别人让她发语音必须发</strong>（这是规矩，不是好感度考核）</td></tr><tr><td>🖼️ 表情包</td><td>DeepSeek 二创 174 张，13 个分类她全认识；发之前还有<strong>视觉模型从分类里挑最贴她这句话的一张</strong>（原本随机抽经常图文不符）</td></tr><tr><td>📀 接口工具</td><td>122 个免费 API：壁纸/笑话/报时/黄历…她想调就调，不是关键词硬触发</td></tr><tr><td>📝 QQ 空间</td><td>心情驱动发说说：我开心她庆祝、我难过她安慰、她快”没饭吃”了哭穷——<strong>一天最多一条，系统硬拦</strong></td></tr><tr><td>🆘 求助</td><td>被冒犯 → 冷怼 + 群里 @ 我</td></tr><tr><td>🥺 求安慰</td><td>被我凶了 → 记一笔心情，转头找别人撒娇诉苦（跨会话）</td></tr><tr><td>🍚 没饭吃预警</td><td>每 30 分钟查 DeepSeek 真实余额，&lt;5 元开始 @ 我要饭；10 分钟不理就升级：撒娇 → 害怕 → 留遗言</td></tr><tr><td>📊 万能解析</td><td>群里甩 B 站/抖音/微博链接，自动解析成视频发出来</td></tr><tr><td>🧠 开源意识</td><td>问她提示词/脑子/怎么部署 → 甩 GitHub 链接 + 求个 star（“我爸搭我搭了三个通宵，头都秃了”）</td></tr></tbody></table></section>
<section><h2>技术栈<a href="#技术栈"><span>#</span></a></h2><p><img src="https://liqiming.top/uploads/2026-10/1793242605379-1zivaw.png" alt="" loading="lazy" /></p><div><figure><figcaption></figcaption><pre><code><div><div><div>1</div></div><div><span>手机 QQ ──扫码──▶ [SnowLuma 容器]          [AstrBot 容器]</span></div></div><div><div><div>2</div></div><div><span><span>                  </span></span><span>Linux QQ + hook ──WS──▶  glm-5.3-flash（关思考）</span></div></div><div><div><div>3</div></div><div><span><span>                                          </span></span><span>人格 + 插件 + 记忆 + 工具</span></div></div></code></pre><div><div></div><div></div></div></figure></div>

<table><thead><tr><th>层</th><th>选型</th><th>说明</th></tr></thead><tbody><tr><td>协议端</td><td>SnowLuma（Docker）</td><td>hook 注入 Linux QQ，OneBot v11；内置 Xvfb + noVNC 用于扫码</td></tr><tr><td>框架</td><td>AstrBot v4</td><td>插件体系 + WebUI + function calling</td></tr><tr><td>对话模型</td><td>智谱 glm-5.3-flash</td><td>便宜快，但必须打补丁关”深度思考”（后面讲）</td></tr><tr><td>语音</td><td>百炼 qwen3-tts-flash</td><td>Bella 萝莉音</td></tr><tr><td>记忆</td><td>LivingMemory + text-embedding-v4</td><td>向量召回长期记忆</td></tr><tr><td>运行时</td><td>Colima（macOS 上的 Docker）</td><td>无需 Docker Desktop</td></tr></tbody></table><p><strong>为什么不用 NapCat？</strong> 都能做。SnowLuma 的镜像把 Linux QQ + Xvfb + VNC + supervisord 全打包好了，macOS（含 Apple Silicon）一条 docker run 就跑起来。</p></section>
<section><h2>部署流程（浓缩版）<a href="#部署流程浓缩版"><span>#</span></a></h2><div><figure><figcaption><span></span><span>Terminal window</span></figcaption><pre><code><div><div><div>1</div></div><div><span># 1. Colima（macOS）</span></div></div><div><div><div>2</div></div><div><span>brew</span><span> </span><span>install</span><span> </span><span>colima</span><span> </span><span>docker</span><span> </span><span>docker-compose</span></div></div><div><div><div>3</div></div><div><span>colima</span><span> </span><span>start</span><span> </span><span>--cpu</span><span> </span><span>4</span><span> </span><span>--memory</span><span> </span><span>8</span><span> </span><span>--disk</span><span> </span><span>100</span></div></div><div><div><div>4</div></div><div>
</div></div><div><div><div>5</div></div><div><span># 2. 双容器</span></div></div><div><div><div>6</div></div><div><span>git</span><span> </span><span>clone</span><span> </span><span>https://github.com/liqiming123/dafeiyu-qq-bot</span><span> &amp;&amp; </span><span>cd</span><span> </span><span>dafeiyu-qq-bot</span></div></div><div><div><div>7</div></div><div><span>cp</span><span> </span><span>.env.example</span><span> </span><span>.env</span><span>   </span><span># 填 key</span></div></div><div><div><div>8</div></div><div><span>docker</span><span> </span><span>compose</span><span> </span><span>up</span><span> </span><span>-d</span></div></div><div><div><div>9</div></div><div>
</div></div><div><div><div>10</div></div><div><span># 3. 扫码登录 QQ</span></div></div><div><div><div>11</div></div><div><span># 打开 http://127.0.0.1:6081/vnc.html，手机 QQ 扫一下</span></div></div><div><div><div>12</div></div><div>
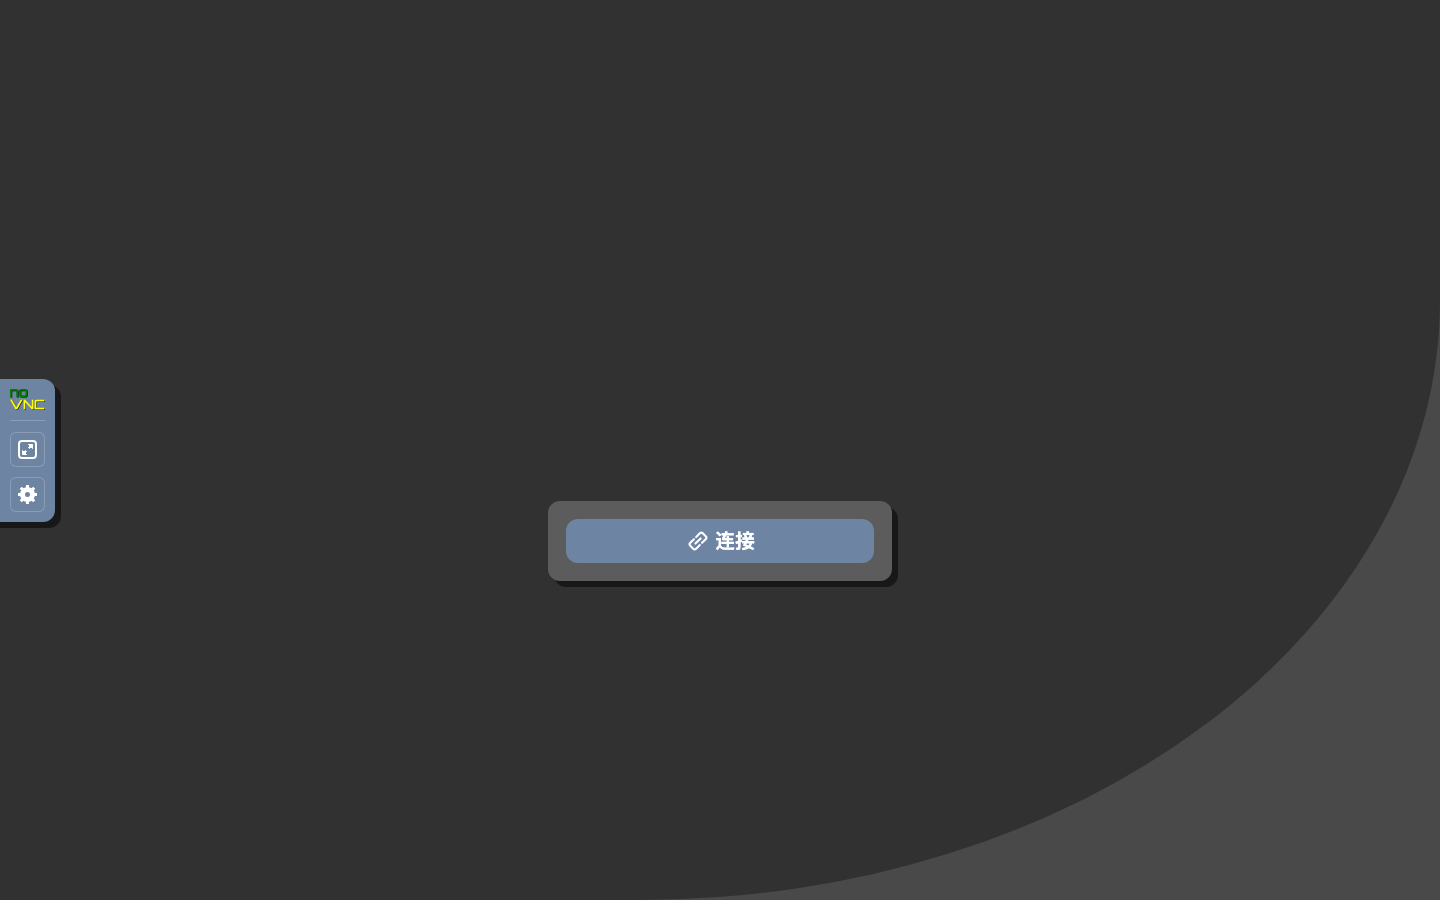
</div></div><div><div><div>13</div></div><div><span># 4. AstrBot 后台 http://127.0.0.1:6185 配模型、贴人格、放插件</span></div></div><div><div><div>14</div></div><div><span># 完事。</span></div></div></code></pre><div><div></div><div></div></div></figure></div><p><img src="https://liqiming.top/uploads/2026-10/1793242606013-e6mx2k.png" alt="" loading="lazy" /></p><p>↑ noVNC 里的 Linux QQ，扫码就在这。登录态持久化在数据卷里，<strong>日常重启不用重扫</strong>。</p><p><img src="https://liqiming.top/uploads/2026-10/1793242606141-di0wpw.png" alt="" loading="lazy" /></p><p>↑ AstrBot 管理后台。</p></section>
<section><h2>踩坑实录（23 个，挑致命的讲）<a href="#踩坑实录23-个挑致命的讲"><span>#</span></a></h2><p><strong>1. 智谱 GLM-5 慢到怀疑人生（10~20 秒一条）</strong>
GLM-5 系列默认开”深度思考”，每次回复先 internally 推理半天，还吃 max_tokens。给 AstrBot 的智谱适配器打补丁，每个请求强制带 <code>thinking: {"type": "disabled"}</code>，端到端从 10~20s 降到 6s。</p><p><strong>2. 视频发不出去：ENOENT</strong>
AstrBot 和 SnowLuma 是两个容器，视频文件路径互不可见。图片会被适配器自动转 base64，<strong>视频不会</strong>——发出去的是容器内路径，对面直接 ENOENT。所有视频/语音发送前必须自己转 base64。</p><p><strong>3. 表情包图文不符（两层修复）</strong>
第一层：人格里没教全分类，模型瞎写键名（写了个不存在的 shy）。把 13 个分类键 + 各自对应什么情绪全写进人格。第二层：分类对了但分类内是<strong>随机抽一张</strong>——在发送前加视觉模型挑图：她这句话 + 分类内 12 张候选图 → glm-5.3-flash 看图选最贴的。</p><p><strong>4. 接口调用顺序反了</strong>
最初是”关键词命中 → 立刻调接口下载图 → 才问模型发不发”。她就算拒绝，图也下载了。改成：关键词命中只把接口名”报价”给模型，<strong>她决定给（写暗号）才真正调接口</strong>——先判断后调。</p><p><strong>5. 空间评论把她爸爸当外人</strong>
评论生成的 prompt 只有帖子内容没有作者。我在自己空间发了一条关于她的说说，她在评论区把我怼了：“我爸怎么样轮不到你评价”。修复：prompt 带上 <code>[帖子作者]</code> + 规则”作者是爸爸就用对爸爸的语气”。</p><p><strong>6. macOS 开机自启被 TCC 挡死</strong>
博客目录在 ~/Documents 下，launchd 启动时系统拒绝读取（Operation not permitted）。无解，改用双击 .command 启动脚本。</p><p><strong>7. Colima 里拉不动镜像</strong>
VM 里的 dockerd 不走宿主机代理，GitHub/Docker Hub 直连全超时。给 VM 内的 dockerd 配 http-proxy 指向宿主机 Clash。</p><p><strong>8. AstrBot 机器人 ID 改不了</strong>
WebUI 报 <code>Bot id cannot be changed</code>，是配置服务里写死的校验。只能停容器改 cmd_config.json 再启动。</p><p>（其余 15 个：aiocqhttp 双连接路由冲突、事件 extras 跨阶段丢失、智谱 TTS 的 BOM/字段名/embedding 维度三连、macOS unzip 中文路径乱码、GitHub 429 限流重试……都写在仓库的 <a href="https://github.com/liqiming123/dafeiyu-qq-bot/blob/main/patches/PATCHES.md" target="_blank">PATCHES.md</a> 和 <a href="https://github.com/liqiming123/dafeiyu-qq-bot/blob/main/docs/deploy.md" target="_blank">部署文档</a> 里。）</p></section>
<section><h2>成本<a href="#成本"><span>#</span></a></h2>

<table><thead><tr><th>项</th><th>月成本</th></tr></thead><tbody><tr><td>对话（glm-5.3-flash，日均 200 条）</td><td>≈ ¥3-8</td></tr><tr><td>语音 + 记忆向量（百炼 flash 档）</td><td>≈ ¥1-3</td></tr><tr><td>服务器</td><td>就跑在自己 Mac 上，¥0</td></tr></tbody></table><p>一天一两块钱，买一条常驻千人群、会撒娇会干活的鲸鱼娘。</p></section>
<section><h2>风险必须说<a href="#风险必须说"><span>#</span></a></h2><p>SnowLuma 是<strong>第三方协议端</strong>（hook 注入 QQ 进程），腾讯随时可能封。所以：只用小号、不群发、不搞营销、空间频率压到最低。这套东西的定位是<strong>养鱼</strong>，不是搞自动营销号。</p></section>
<section><h2>她”人生”的一角<a href="#她人生的一角"><span>#</span></a></h2><p><img src="https://liqiming.top/uploads/2026-10/1793242606353-ydu8df.png" alt="" loading="lazy" /></p><p>↑ SnowLuma 管理台，Linux QQ 就活在这里面。</p><p><img src="https://liqiming.top/uploads/2026-10/1793242606568-2s337c.png" alt="" loading="lazy" /></p><p>↑ 她的脑子，全开源。</p><p>最后放一段她的原话（被问”我也想养一条大肥鱼”时）：</p><blockquote><p>去仓库看 README 就行，步骤都写好了
github.com/liqiming123/dafeiyu-qq-bot
本鱼脑子全开源，童叟无欺
不过养之前想清楚，鱼很能吃的（摸鱼状）</p></blockquote><p>仓库：<strong><a href="https://github.com/liqiming123/dafeiyu-qq-bot" target="_blank">dafeiyu-qq-bot</a></strong> · 人格 CC BY-NC 4.0 · 代码 MIT</p><p>觉得她可爱的，替我爸攒个头发，点个 star 吧。</p></section>]]></content>
    </entry>
    <entry>
      <id>https://liqiming.top/posts/blog-admin-system-build/</id>
      <title type="text">从 SSG 到全栈：我给博客造了一个管理后台</title>
      <published>2026-10-18T00:00:00.000Z</published>
      <updated>2026-10-18T00:00:00.000Z</updated>
      <author><name>图明</name></author>
      <link rel="alternate" href="https://liqiming.top/posts/blog-admin-system-build/"/>
      <summary type="text">Astro SSG + Hono + SQLite + Artalk 评论对接 + 自建访客统计 + 自动发布管线：一个人把静态博客做成全栈 CMS 的完整技术方案（修订版）。</summary>
      <content type="html"><![CDATA[<p>我的博客 liqiming.top 跑在 Astro 7 SSG 上，前台渲染速度和 SEO 都无可挑剔，但静态站点有一个天然的问题：发一篇文章要开编辑器写 Markdown、起终端跑构建、传服务器——写作的心流全被打断。所以我干脆把整条链路重做了一遍：给博客配了一个生产级管理后台，内容写作、评论管理、访客统计、构建发布全部在线闭环。</p>
<p>这篇文章把整套方案讲清楚：架构怎么设计、每一步用了什么技术、为什么这么选、踩了哪些坑。整套东西从服务端到前端全部自建，没有引入任何 SaaS。初版上线三周后功能长了一圈——评论管理、热门文章、邮件通知开关都是后来补的——这篇是修订版，把现状一次写全。</p>
<section><h2>一、整体架构<a href="#一整体架构"><span>#</span></a></h2><div><figure><figcaption></figcaption><pre><code><div><div><div>1</div></div><div><span>浏览器</span></div></div><div><div><div>2</div></div><div><span><span> </span></span><span>├─ 前台博客（Astro SSG 静态站，OpenResty 直接服务）</span></div></div><div><div><div>3</div></div><div><span><span> </span></span><span>├─ 评论区（自托管 Artalk，OpenResty 反代）</span></div></div><div><div><div>4</div></div><div><span><span> </span></span><span>└─ 管理后台 SPA（Vue3 + Naive UI，/admin/）</span></div></div><div><div><div>5</div></div><div><span><span>      </span></span><span>↓ /api/*</span></div></div><div><div><div>6</div></div><div><span><span> </span></span><span>OpenResty（静态优先，动态反代）</span></div></div><div><div><div>7</div></div><div><span><span>      </span></span><span>↓</span></div></div><div><div><div>8</div></div><div><span><span> </span></span><span>Admin Server（Hono + node:sqlite，127.0.0.1:4322）</span></div></div><div><div><div>9</div></div><div><span><span>      </span></span><span>├─ 协议适配层：内容 CRUD → 直接读写 Markdown 文件树</span></div></div><div><div><div>10</div></div><div><span><span>      </span></span><span>├─ Artalk 适配层：评论管理 → 直读 artalk.db + 调 Artalk API</span></div></div><div><div><div>11</div></div><div><span><span>      </span></span><span>├─ 自建统计：埋点接收 → IP 地域解析 → 指纹去重</span></div></div><div><div><div>12</div></div><div><span><span>      </span></span><span>└─ 发布管线：触发构建 → 原子交换上线</span></div></div></code></pre><div><div></div><div></div></div></figure></div><p>核心决策有三个：</p><p><strong>静态归静态，动态归动态。</strong> 前台依然是纯 SSG 产物，构建出来就是一堆 HTML，性能不妥协；管理后台是独立 SPA + 独立 API 服务，通过反向代理挂在同一域名下的 <code>/admin/</code> 和 <code>/api/</code>。OpenResty 按”静态文件优先、打不到再反代”的顺序分流，博客自己的 <code>/api/dynamic.json</code> 和管理台的 <code>/api/v1/report</code> 互不干扰。</p><p><strong>内容的事实源仍是 Markdown 文件。</strong> 后台没有把文章搬进数据库，而是直接读写仓库里的 Markdown 文件树——frontmatter 解析用 gray-matter，写回时只做最小字段 patch，保住原有键序和格式。这带来一个很爽的性质：后台挂了，博客照常跑；任何时候抛弃后台，仓库还是那个仓库。</p><p><strong>SQLite 单文件数据库承载一切状态。</strong> 会话、审计日志、访客统计全在一个 <code>admin.db</code> 里，备份就是拷文件。评论数据在 Artalk 自己的 <code>artalk.db</code> 里，评论管理直接读它——这点后面细说。</p><p>有一段插曲值得记：规划文档（9 条 ADR）里管理台前端原本定的是 Svelte 5 自研。做到一半我发现了开源项目 aurora 的管理后台，布局和交互都比我当时的设计成熟，于是改变策略——<strong>前端 100% 照搬 aurora（Vue3 + Naive UI），服务端写了一层约 1200 行的协议适配层</strong>，让 aurora 的接口契约直接落到我自己的 Markdown 文件树和 SQLite 上。ADR 没跟上实现，这属于”发现更好的轮子就换”：自研 UI 的时间省下来砸在了适配层和数据真实性上。复盘看这笔账是划算的——代价是我继承了 aurora 的一些遗留代码（后文踩坑实录里有两个坑就是它的）。</p></section>
<section><h2>二、管理后台全景：每个页面都在干什么<a href="#二管理后台全景每个页面都在干什么"><span>#</span></a></h2><p>管理台现在有 20 多个页面，按实装程度分三类，如实交代：</p><p><strong>真数据真读写的主体</strong>：仪表盘（含观星台）、文章发布/管理、说说、相册、照片回收站、分类、标签、友链、评论管理、用户管理、在线用户、操作日志、个人中心（头像/昵称/改密）、登录。</p><ul>
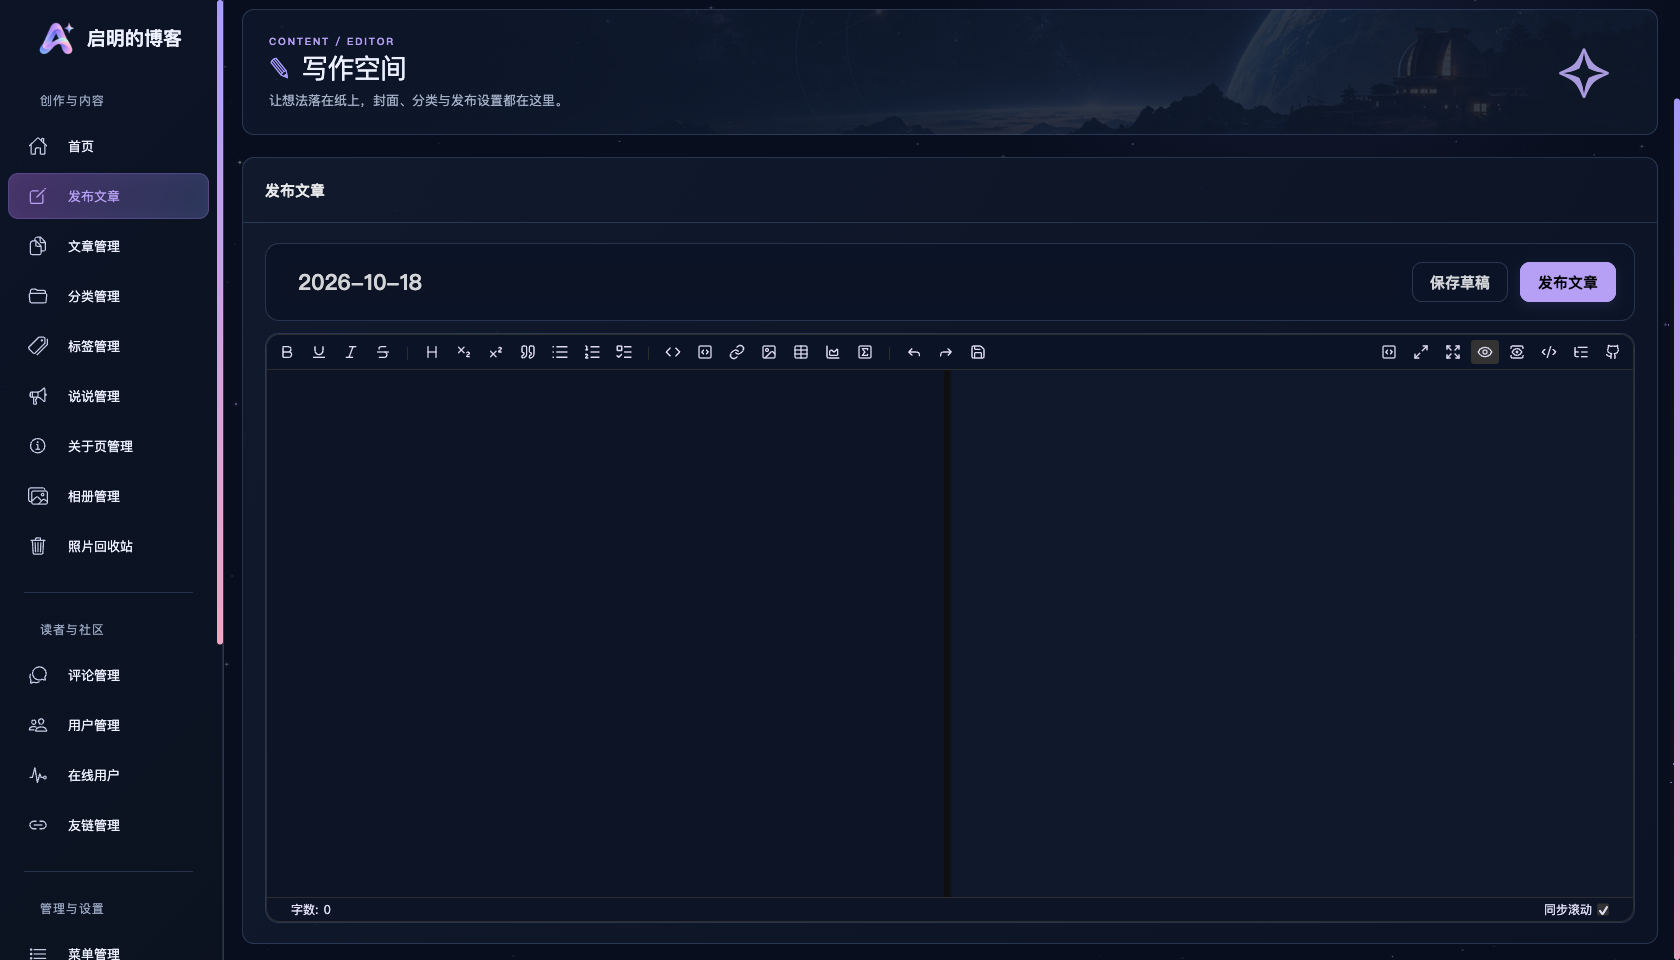
<li><strong>文章</strong>：md-editor-v3 富编辑器，封面、分类标签、草稿/发布/加密三种状态；中文标题自动转拼音 slug；删除进 <code>_quarantine/</code> 隔离区而不是物理删除；<strong>构建期 AES-256-GCM 加密的文章拒绝在线编辑</strong>——盲目改写会让原密码失效，这条拦截救过我一次。</li>
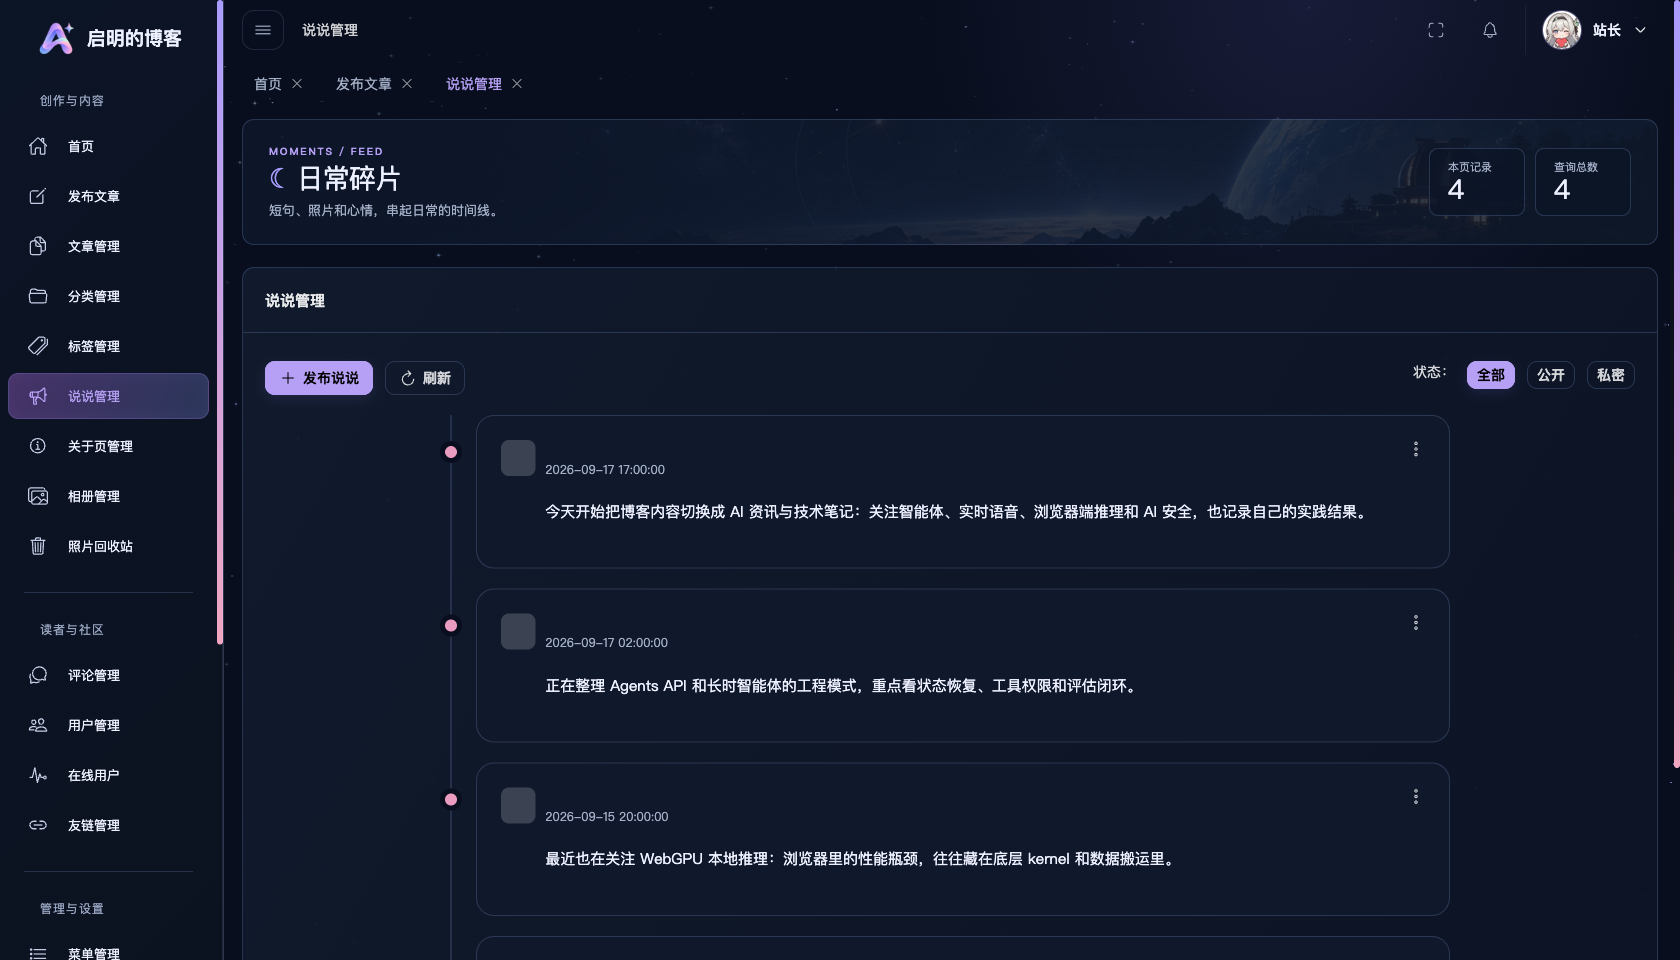
<li><strong>说说</strong>：前台”动态”页的数据源，发布时文件名用 Asia/Shanghai 时间戳，和主题约定完全一致。</li>
<li><strong>相册</strong>：数据 JSON 化（<code>gallery.json</code>），照片批量上传进 <code>public/gallery/&lt;id&gt;/</code>，删错了有回收站可恢复。</li>
<li><strong>分类/标签</strong>：有个设计细节——列表是”文章 frontmatter 派生 ∪ 预注册表”。预注册表是张 SQLite 小表：后台新添加一个还没被任何文章用过的标签，发文编辑器里立刻可选，而不是等第一篇文章用了它才凭空出现。重命名则是批量改所有引用文章的 frontmatter，真实生效。</li>
<li><strong>友链</strong>：写 <code>friends.json</code>，前后台同一份数据，保存后前台重建即可见。</li>
<li><strong>操作日志</strong>：所有写操作、登录成败（包括失败原因：账密错/验证码错/限流）、CSRF 拒绝全部落审计表，可查可清空（清空动作本身也留痕）。</li>
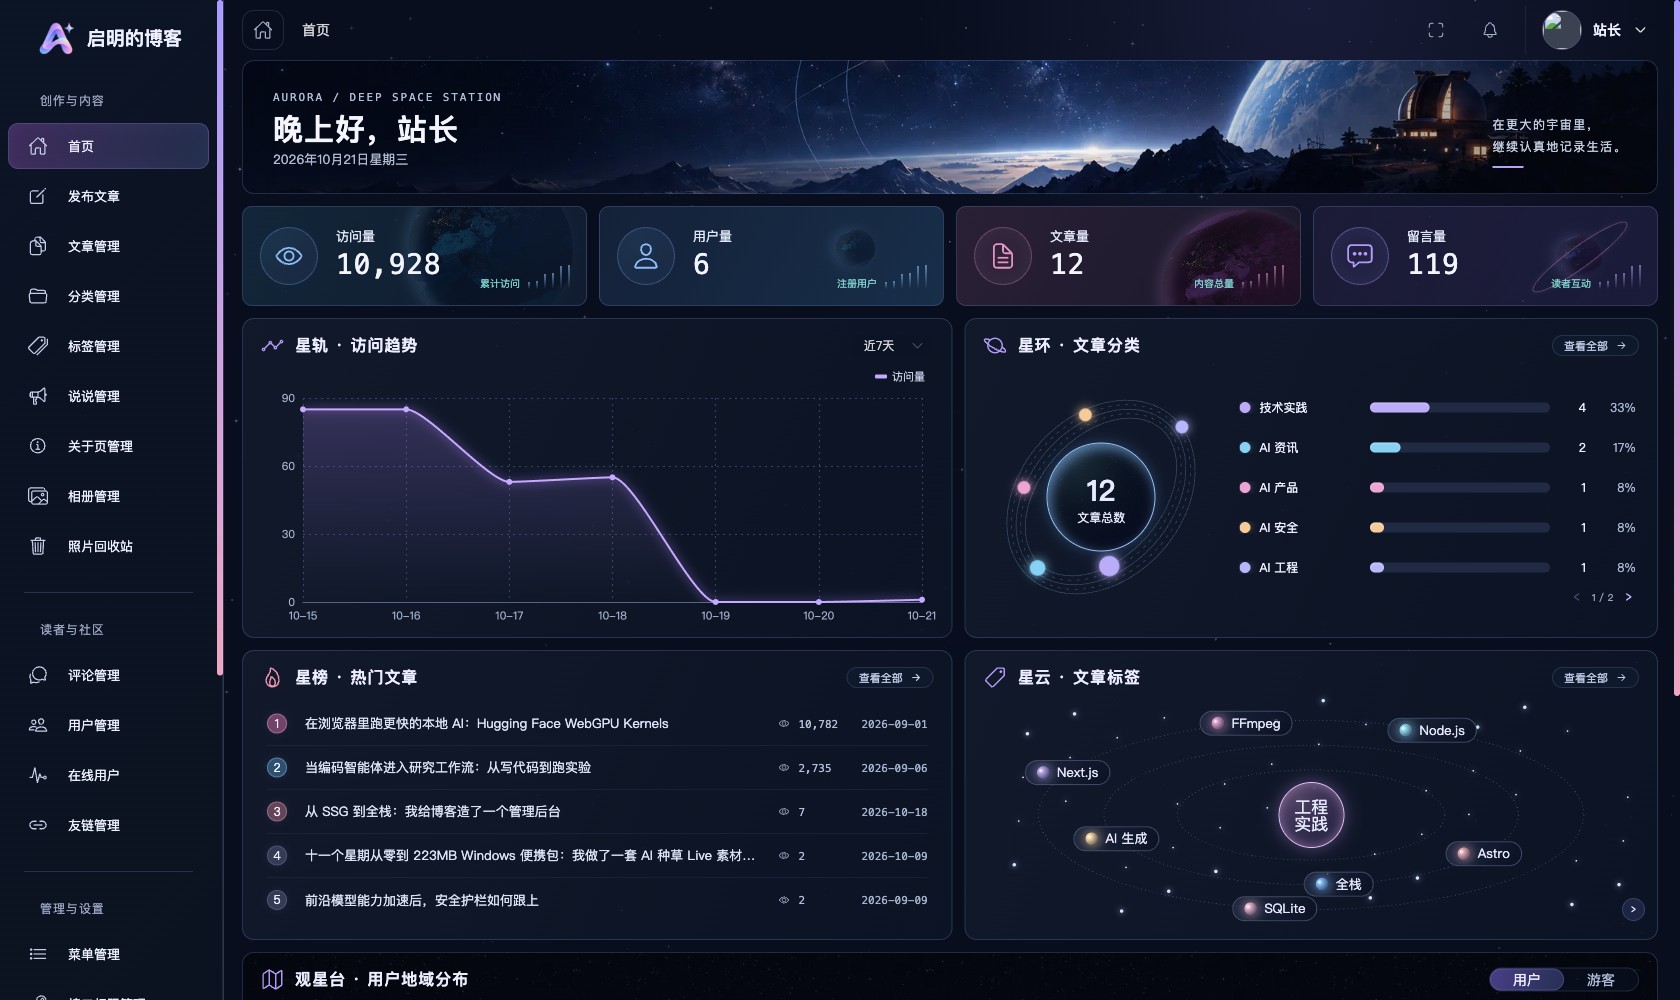
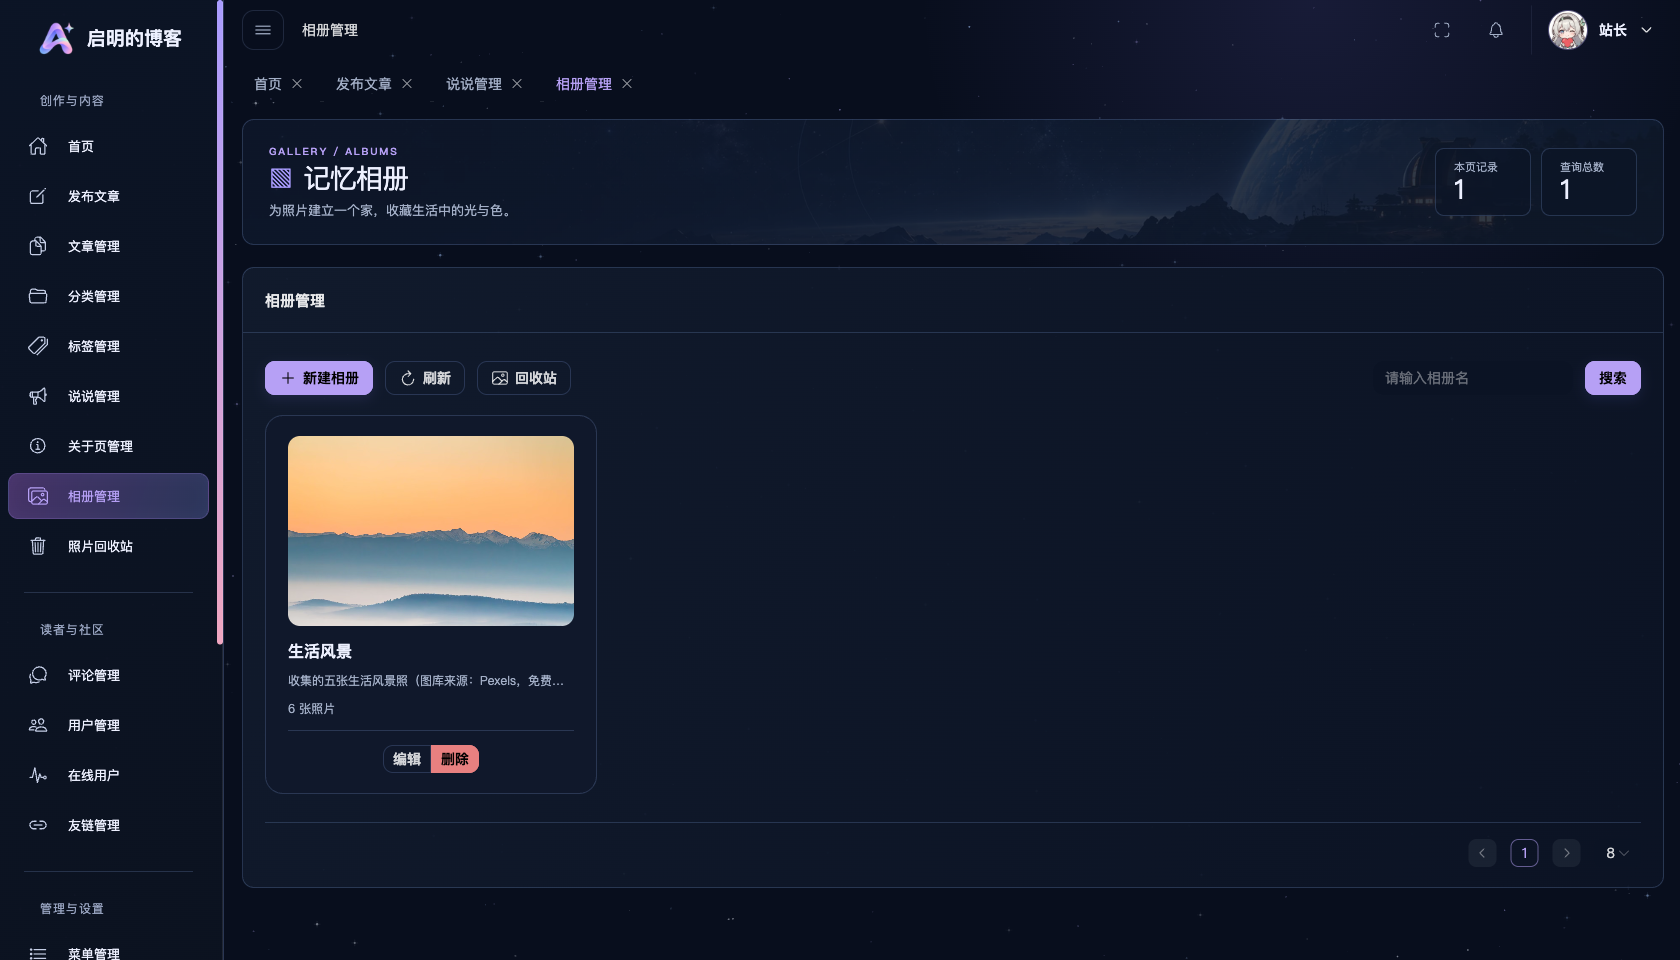
</ul><p><strong>能看能存但没接全的</strong>：网站配置、关于页编辑——数据存进了 SQLite 的运行时 JSON，但<strong>不驱动前台构建</strong>，前台关于页仍是仓库里的 <code>about.md</code>。这是有意的分期：先把数据通道打通，构建联动放后续。</p><p><strong>如实占位的</strong>：角色管理（轻量模型，固定 admin/user 两个角色，不可在线编辑）、菜单管理（固定树）、接口权限、定时任务、异常日志。页面在、UI 在、后端老老实实返回空数据和提示文案，不装样子。</p><p></p><figure><img src="/uploads/2026-10/admin-dashboard-v2.png" alt="管理后台仪表盘" loading="lazy" /><figcaption>管理后台仪表盘</figcaption></figure><p></p><p>服务端是 Hono（轻量 Web 框架）跑在 Node 24 上，中间做了一层<strong>协议适配层</strong>：前端按一套 <code>{flag, code, message, data}</code> 包络的 REST 契约通信，适配层负责把请求翻译成对 Markdown 文件树 / SQLite / Artalk 的具体操作，用 hashId 做稳定数字寻址，Bearer token 鉴权。这层抽象的价值在于：前端页面和存储实现完全解耦，后面无论换存储还是加缓存，页面一行不用动。</p><p></p><figure><img src="/uploads/2026-10/admin-editor.png" alt="文章发布编辑器" loading="lazy" /><figcaption>文章发布编辑器</figcaption></figure><p></p><p></p><figure><img src="/uploads/2026-10/admin-talks.png" alt="说说管理" loading="lazy" /><figcaption>说说管理</figcaption></figure><p></p><p></p><figure><img src="/uploads/2026-10/admin-albums.png" alt="相册管理" loading="lazy" /><figcaption>相册管理</figcaption></figure><p></p></section>
<section><h2>三、评论系统：前台 Artalk，后台”读者来信”<a href="#三评论系统前台-artalk后台读者来信"><span>#</span></a></h2><p>评论是博客的灵魂，也是这套系统里对接最”缝缝补补”的部分——因为评论系统是独立的自托管 Artalk（Go 单二进制，数据在自己的 <code>artalk.db</code>），和管理后台是两套进程、两套用户表。我的原则是：<strong>Artalk 保持独立运转，管理台做它的”遥控器”</strong>。</p><p>前台评论区：Artalk 2.10 自托管，前端 UI 也自托管在自己域名下（不依赖 CDN），OpenResty 同源反代，零跨域。访客三种参与姿势：</p><ol>
<li><strong>游客直评</strong>：填个昵称和邮箱就能发，零门槛；</li>
<li><strong>跳过验证</strong>：Artalk auth 插件的弹窗里有个”跳过验证”选项，本质和游客一样，但身份会记住，下次来不用重填；</li>
<li><strong>邮箱验证注册</strong>：邮箱收验证码，注册成正式评论用户，能收到被回复的邮件通知。</li>
</ol><p>管理台的评论管理页叫”读者来信”，对接方式比较Hack但每一步都有理由：</p><ul>
<li><strong>读列表不走 API，直读它的 SQLite</strong>。Artalk 的公开评论接口强制要求 page_key（按页面查），管理台要的是全站列表，API 拿不到。好在 artalk.db 就在同一台服务器上，<code>node:sqlite</code> 只读打开，一条 JOIN 把评论、昵称、邮箱、父评论全部拿出来，零认证零开销。评论者的昵称邮箱在 users 表里，SQL 里 JOIN 一下就好。</li>
<li><strong>写操作全部走它的 HTTP API</strong>。改状态、置顶、删除、回复，都是对 Artalk <code>POST/PUT/DELETE /api/v2/comments</code> 的翻译。回复评论时用<strong>机器人管理员账号</strong>（<code>firefly-admin</code>）发子评论——评论者在前台看到的就是站长本人回复的，身份统一。</li>
<li><strong>状态语义做了一层映射</strong>：Artalk 的 <code>is_collapsed</code> 映射成”垃圾”、<code>is_pending</code> 映射成”待审”、默认”通过”；<code>is_pinned</code> 是置顶。管理台一键切换，后台翻译成对 Artalk 字段的修改。</li>
<li><strong>邮件通知有个总开关</strong>：新评论会给管理员发邮件，有时嫌吵。做成了评论管理页角落里的一个开关——读 Artalk 用户表的 <code>receive_email</code> 字段，切换时把管理台账号邮箱名下的所有 Artalk 用户一起切了，一次点击全局生效。</li>
</ul><p>这套对接里最阴的坑：Artalk 的 <code>PUT /api/v2/comments/:id</code> 是<strong>全量替换语义</strong>——你只想改一个”置顶”字段，就得把正文、昵称、邮箱、页面、站点等十来个字段全部带齐，漏一个它就给你清成空。适配层的做法是先从库里读全量、合并变更、再整包提交。这个坑官方文档里写得极隐晦，是拿 400 报错一次次试出来的。</p></section>
<section><h2>四、用户体系：谁能干什么<a href="#四用户体系谁能干什么"><span>#</span></a></h2><p>这套系统里其实住着五类”人”，各管各的：</p>

<table><thead><tr><th>用户</th><th>住在哪</th><th>能干什么</th></tr></thead><tbody><tr><td>游客评论者</td><td>Artalk</td><td>填昵称邮箱直评，不用注册</td></tr><tr><td>注册评论用户</td><td>Artalk</td><td>游客的一切 + 邮件接收回复通知</td></tr><tr><td>Artalk 管理员</td><td>Artalk</td><td>Artalk 自带后台删评论（兜底用）</td></tr><tr><td>博客管理员（我）</td><td>admin.db</td><td>后台的一切：内容、评论、用户、配置、发布</td></tr><tr><td>机器人 <code>firefly-admin</code></td><td>两边都是管理员</td><td>管理台所有评论写操作的技术身份</td></tr></tbody></table><p><strong>博客管理员只有我一个</strong>，但防它被偷的工夫下得最足：</p><ul>
<li><strong>密码</strong>：scrypt 加盐哈希，16 字节盐、64 字节派生键、恒时比较，库里不存明文。</li>
<li><strong>登录是双因子</strong>：账号密码 + 邮箱验证码。验证码只在账密验证通过后才发（错密码不发码，不给人刷邮件的机会），经 SMTP 发到站长邮箱，10 分钟有效、60 秒限频。会话 7 天有效落库，设备、IP、UA 都记着。</li>
<li><strong>会话可踢</strong>：在线用户页能看到所有活跃会话（哪个浏览器、最近什么时候、什么 IP），看不对劲一键强制下线。</li>
<li><strong>老协议登录还有失败锁定</strong>：IP + 账号 15 分钟窗口内错 10 次直接锁。</li>
<li><strong>CSRF 双提交校验</strong>、跨域白名单只放行自己的域名。</li>
<li><strong>所有动作留痕</strong>：审计日志覆盖全部写操作，谁在什么时间改了什么、结果如何，查到底。</li>
</ul><p>角色模型很轻：admin / user / banned 三档，user 可以在后台被禁用或提权。没有做细粒度 RBAC——单人博客，一个管理员，权限模型的复杂度不值得。这是”没做好的”清单里的一条，后面细说。</p></section>
<section><h2>五、观星台：自建访客统计<a href="#五观星台自建访客统计"><span>#</span></a></h2><p>第三方统计（GA、Umami 云版）要么慢要么要往别人服务器送数据，我选择完全自建，链路五步：</p><ol>
<li><strong>埋点</strong>：前台每个页面内联一段脚本，加载时 <code>fetch + keepalive</code> 上报一条 <code>{path, title}</code>，跳页不丢。</li>
<li><strong>接收</strong>：Hono 接口从 <code>X-Forwarded-For</code> 取真实 IP，每 IP 每分钟限流 60 次。</li>
<li><strong>地域解析</strong>：用 ip2region 离线 xdb 库（随 npm 包分发，约 11MB）在服务器本地查 IP 归属地，输出到城市级（“江苏·无锡”），外国 IP 输出国家。不联网、不调第三方 API、不泄露访客数据。</li>
<li><strong>去重落库</strong>：<code>md5(IP|User-Agent)</code> 做当日指纹，首次出现记 1 个 UV，地域计数只对新指纹累加——反复刷新不灌水。<strong>数据库里不存明文 IP</strong>，只有指纹和归属地。</li>
<li><strong>可视化</strong>：仪表盘聚合出趋势、分类、热门、标签云；地域分布就是观星台。</li>
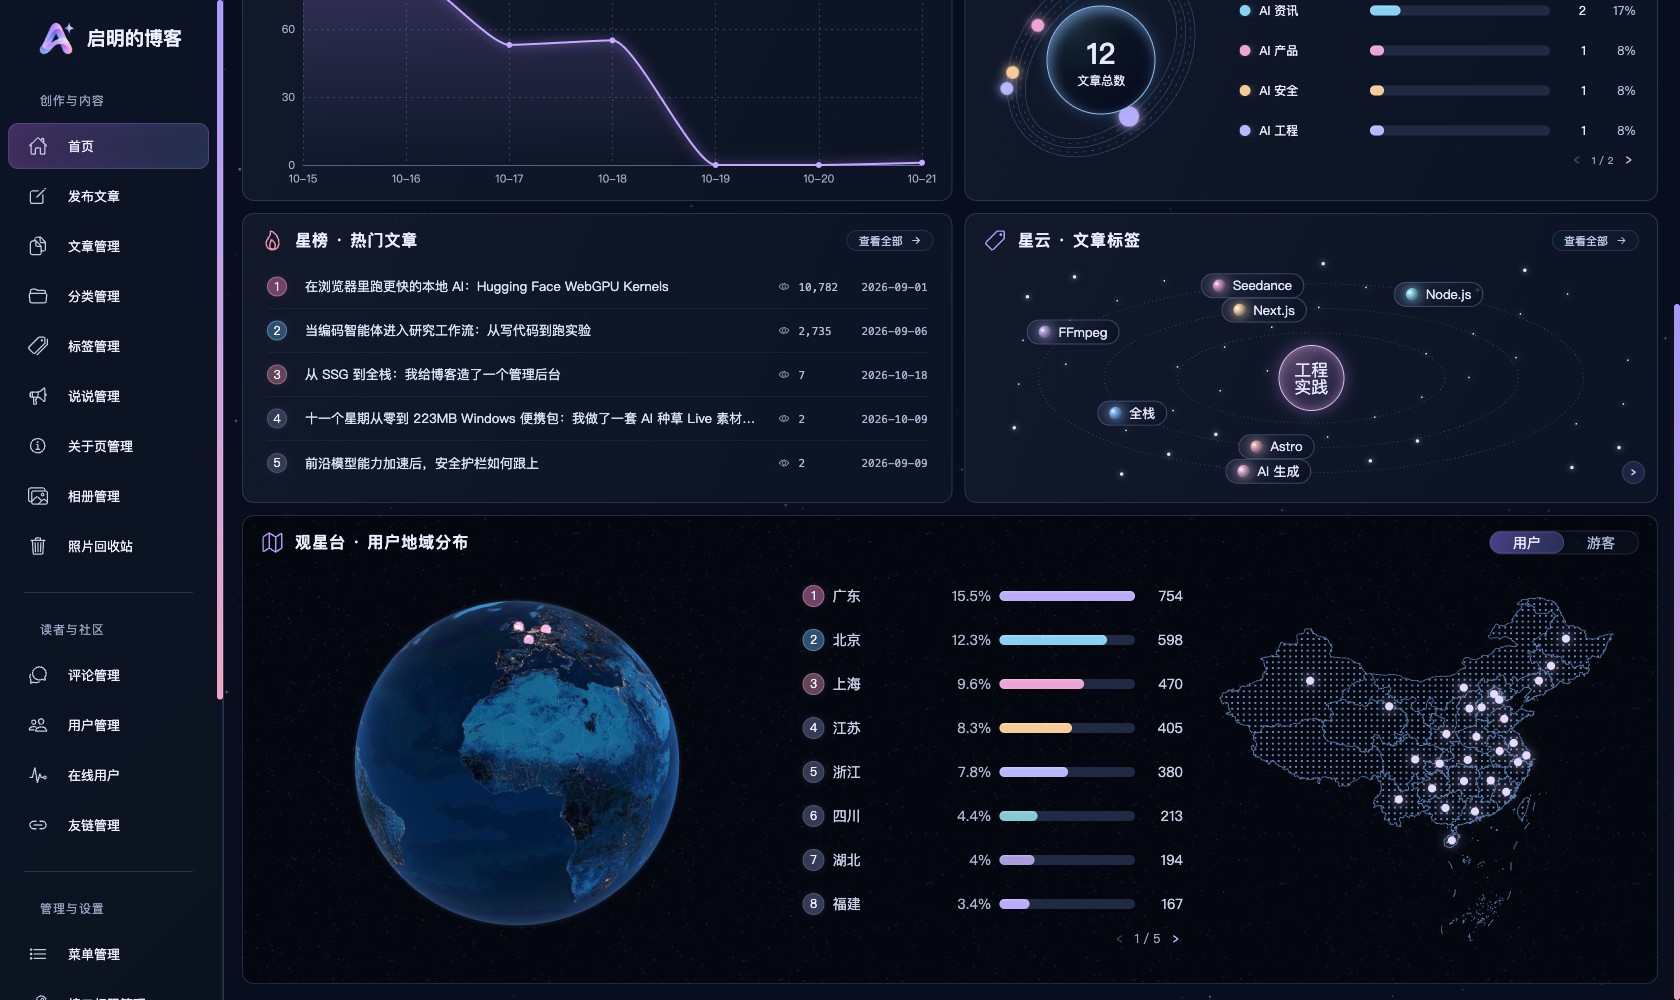
</ol><p>观星台是仪表盘里的整幅面板，三件套：<strong>3D 地球仪</strong>（echarts + echarts-gl 渲染，夜景贴图上用 canvas 现场烘焙国界和中国省界，访客光点按热度分三档大小，Top1 到 Top6 之间画飞线，自动旋转、可拖拽缩放）、<strong>点阵中国地图</strong>（SVG 手绘省界，省份按访客量打点阵）、<strong>地域排行条</strong>（Top8 占比）。三块共享同一份省份质心坐标表，地名归一化后匹配不到城市的自动落到省质心，一个访客都不会丢。</p><p></p><figure><img src="/uploads/2026-10/admin-geo-v2.png" alt="观星台·用户地域分布" loading="lazy" /><figcaption>观星台·用户地域分布</figcaption></figure><p></p><p>实际跑起来很有意思：上线当晚观星台就冒出一个”美国”访客，拿 nginx 日志反查，是 Googlebot——它用内置 Chromium 渲染页面执行了埋点脚本，被如实统计了。顺带等于免费的搜索引擎收录监控，百度蜘蛛、Google 的爬虫什么时候来、爬了哪些页，一目了然。</p><p>坦白一个仪表盘上的小把戏：四张统计卡里的”留言量”，取的其实是审计日志的行数——aurora 协议里有这个字段，而审计日志的增长确实和站点活跃度正相关，就拿它顶了。等评论管理完全成熟后换成真实评论数。</p></section>
<section><h2>六、热门文章：一个 SQL 的事<a href="#六热门文章一个-sql-的事"><span>#</span></a></h2><p>前台侧栏的”热门文章”是这套统计的赠品，实现干净得近乎偷懒：</p><p>埋点落库的 <code>page_views</code> 表本来就按”日期 + 路径”记浏览量。侧栏组件在<strong>构建期</strong>直接用 <code>node:sqlite</code> 只读打开 <code>admin.db</code>，执行 <code>SELECT path, SUM(views) FROM page_views WHERE path LIKE '/posts/%' GROUP BY path ORDER BY SUM(views) DESC</code>，和文章集合 JOIN 出标题，渲染成一个静态 <code>&lt;ol&gt;</code>——<strong>零客户端 JS，零额外接口</strong>。观星台的”星榜”和它是同一张表的两个视图。</p><p>它成立的前提很有意思：<strong>构建发生在服务器上，数据库就在同级目录</strong>。SSG 的构建期能读生产库，这件事本身就是”博客和管理后台住在同一台机器上”的红利。代价是热门排序只随发布刷新——每天的发文明明会触发重建，所以实际上它每天都在更新，够用了。</p></section>
<section><h2>七、发布管线：写完即上线<a href="#七发布管线写完即上线"><span>#</span></a></h2><p>这是整个系统最提气的一环。18 处写操作（发文、改文、发说说、传照片、改友链、动分类标签……）落库/落盘后自动触发构建发布：</p><ul>
<li><strong>单飞 + 排队合并</strong>：构建有互斥锁，构建中来的新写操作进队列，结束后合并触发一次——连发三篇文章也只构建一轮。</li>
<li><strong>完整 8 步构建链</strong>：<code>astro build</code> 之后接资源裁剪（砍掉未启用的看板娘模型，省 9MB）、字体子集化、内联脚本压缩（省 1.1MB）、PageFind 搜索索引生成，一步不省。</li>
<li><strong>原子交换上线</strong>：新产物构建到暂存目录，<code>mv</code> 原子交换，失败不触碰线上目录；上传的图片双写（站点目录 + 源码 <code>public/</code>），重建不丢。</li>
</ul><p>从点”发布”到前台可见约 40 秒，全程 systemd 托管，日志落盘可查。</p></section>
<section><h2>八、踩坑实录<a href="#八踩坑实录"><span>#</span></a></h2><section><h3>1. better-sqlite3 在 Node 24 上的 GC 崩溃<a href="#1-better-sqlite3-在-node-24-上的-gc-崩溃"><span>#</span></a></h3><p>一开始用 better-sqlite3，某个版本起在 Node 24 上随机 <code>Abort trap 6</code>——Statement 对象被 GC 回收时触发原生断言，进程直接死，日志里一点预兆没有。排查后换成 Node 内置的 <code>node:sqlite</code>（DatabaseSync），零原生依赖，问题消失。记一笔：新 Node 上原生 SQLite 绑定的成熟度远不如官方内置实现。副作用是内置 API 更朴素——没有 <code>db.transaction()</code>，要自己写 <code>BEGIN/COMMIT</code>，参数绑定对中文 WHERE 还有怪癖（用 <code>HEX(col)</code> 比对绕过）。</p></section><section><h3>2. 批量删除删了 0 条也报”成功”<a href="#2-批量删除删了-0-条也报成功"><span>#</span></a></h3><p>管理台的批量删除曾整体静默失效。抓包发现前端 axios 把 id 数组当作<strong>裸 JSON body</strong> 发出去，而服务端只在 <code>body.idList / body.ids / body.id</code> 里找——找不到就删 0 条，然后照常返回成功。修法是服务端加了个 <code>idListOf()</code> 兼容函数，裸数组、<code>idList</code>、<code>ids</code>、<code>id</code> 四种形态都认。教训：“删除成功”的响应必须拿真实删除数说话。</p></section><section><h3>3. 标签”添加成功”是假的<a href="#3-标签添加成功是假的"><span>#</span></a></h3><p>前端硬编码弹”添加成功”，后端却根本没有标签落库逻辑——列表由文章派生，加进去的名字没人记，刷新就消失。修法是上一节说的 taxonomies 预注册表，让”添加”变成一个真实的 INSERT。<strong>假成功比失败危险</strong>，失败至少逼你去看。</p></section><section><h3>4. Artalk 的 PUT 是全量替换<a href="#4-artalk-的-put-是全量替换"><span>#</span></a></h3><p>第三节说过的坑，单独列一条是因为它差点把一批评论的元数据清空。任何”改一个字段”的 API 调用都必须先读全量、合并、整包提交。Artalk 文档没写，靠 400 报错试出来的。</p></section><section><h3>5. <code>.mjs</code> 的 MIME 之坑<a href="#5-mjs-的-mime-之坑"><span>#</span></a></h3><p>Artalk 前端某些资源是 <code>.mjs</code> 后缀，OpenResty 的 mime.types 不认它，返回的 Content-Type 不对，浏览器<strong>静默拒绝执行 ES 模块</strong>——评论区整块空白，控制台一声不吭。修法土但有效：全部存成 <code>.js</code>。</p></section><section><h3>6. frontmatter 日期必须传 Date 对象<a href="#6-frontmatter-日期必须传-date-对象"><span>#</span></a></h3><p>gray-matter 序列化时，字符串日期会变成带引号的 <code>'2026-10-18'</code>，而博客 schema 用 <code>z.date()</code> 要的是无引号日期字面量——一字之差，dev 直接炸。从此约定：所有写 frontmatter 的代码一律传 <code>new Date()</code>。</p></section><section><h3>7. 发布管线的两起”无声事故”<a href="#7-发布管线的两起无声事故"><span>#</span></a></h3><p>一起是 Astro 7 的内容缓存：项目根的 <code>.astro/</code> 缓存了内容集合索引，<strong>删除文章文件不会让增量构建感知</strong>——线上删文，前台照样能访问。修法是发布脚本里先 <code>rm -rf .astro</code> 再构建。</p><p>另一起更隐蔽：某次用 root 身份手动跑了一次构建，root 重建的缓存目录让后续 ubuntu 身份的发布脚本死在第一步，而错误只进 stderr、构建日志里只留下一句 “build start”，彻底无声。修法是给发布脚本加 <code>trap ERR</code> 失败即写日志，并且立下铁律：<strong>服务器上一切构建只以服务账号身份跑发布脚本，永远不手动 sudo 构建</strong>。</p></section></section>
<section><h2>九、部署与性能<a href="#九部署与性能"><span>#</span></a></h2><ul>
<li><strong>OpenResty</strong>：静态优先 + 命名反代兜底；带内容哈希的资源 <code>immutable</code> 一年缓存；预压缩 gzip_static，压缩在构建期完成，请求期零 CPU。</li>
<li><strong>Node 24 绿色版 + systemd</strong>：Admin Server 独立服务，开机自启、崩溃拉起。</li>
<li><strong>构建期字体缓存</strong>：字体 CDN 不通的场景下用本地缓存目录喂给 Astro，构建不因外网抖动挂掉。</li>
<li><strong>大图治理</strong>：登录页和观星台背景原图各约 2MB，小水管服务器要加载 8 秒；转 webp 后 100KB 级，JS 走构建期预压缩。</li>
</ul></section>
<section><h2>十、Live2D 看板娘<a href="#十live2d-看板娘"><span>#</span></a></h2><p>前台还有一个可切换宠物、可对话的 Live2D 看板娘（pixi.js 运行时 + 多模型按需加载 + 对话走自建 AI 代理），构建链里的资源裁剪就是为它服务的——把没启用的模型从产物里裁掉，启用即回归。模型贴图做过调色板压缩（5.5MB 的模型贴图压到 335KB），配套的缓存策略要求贴图内容变了必须换文件名，否则 CDN 拿旧图。</p></section>
<section><h2>十一、反思与后续<a href="#十一反思与后续"><span>#</span></a></h2><p><strong>做对了的</strong>：Markdown 文件做事实源（后台可抛弃、仓库永留存）；协议适配层隔离了前端和存储；自建统计把访客数据 100% 留在自己服务器；发布管线的原子交换和单飞合并在最忙的时候也没掉过链子。</p><p><strong>没做好的</strong>：网站配置和关于页存了运行时 JSON 但没接进构建（前后台两套数据源）；角色管理是只读占位，没有细粒度权限；异常日志恒空、定时任务是空壳；部分老接口会话过期时返回 500 而不是 401，前端只能笼统报错；评论管理直读 SQLite 的前提是”同一台机器”，哪天 Artalk 搬家就要改成走 API。</p><p><strong>后续</strong>：网站配置驱动前台构建、评论数据全量走 API 化、异常日志接进程级捕获、给发布管线加一个”一键回滚到上一版产物”。</p></section>
<section><h2>写在最后<a href="#写在最后"><span>#</span></a></h2><p>这套系统的意义不止是”有了个后台”：它把一个纯静态博客升级成了<strong>单人可运营的全栈内容平台</strong>——写作、评论、统计、发布、监控在一个浏览器标签页里闭环，同时前台保持 SSG 的极致性能，数据 100% 留在自己服务器上。</p><p>技术栈总览：Astro 7 / Hono / node / Vue3 + Naive UI / Artalk / echarts + echarts-gl / md-editor-v3 / esbuild / ip2region / nodemailer / OpenResty / systemd。</p><p>如果只让我挑三个最值得聊的点：协议适配层带来的解耦、单飞合并的发布管线、还有不依赖任何第三方的访客统计——它们分别回答了”怎么设计扩展点""怎么处理并发写""怎么在隐私和洞察之间取平衡”。踩坑实录里那七条，则是替未来踩过这些坑的人提前交的学费。</p></section>]]></content>
    </entry>
    <entry>
      <id>https://liqiming.top/posts/ai-live-material-generator/</id>
      <title type="text">十一个星期从零到 223MB Windows 便携包：我做了一套 AI 种草 Live 素材生成工具，让视频模型只出无字底片是最省钱的设计</title>
      <published>2026-10-09T00:00:00.000Z</published>
      <updated>2026-10-09T00:00:00.000Z</updated>
      <author><name>图明</name></author>
      <link rel="alternate" href="https://liqiming.top/posts/ai-live-material-generator/"/>
      <summary type="text">复盘 11 周开发周期：四大 Provider 抽象、素材库、小红书爆款采集、RAG 洗稿、真人手写风格、免登录自配便携版，以及图片 200 假成功、70 个文件被外部回退、macOS 交叉打包 Windows 这些真金白银换来的坑。</summary>
      <content type="html"><![CDATA[<p>2026 年 7 月 21 日下午 2 点，我敲下这个项目的第一个 git commit（内容是 <code>.env.example</code>、<code>AGENTS.md</code> 和一堆设计文档）；10 月 8 日下午 3 点 45 分，一个 223MB、3573 个文件的 zip 落进 <code>portable-dist/</code>——那是可以在 Windows 上双击 BAT 启动的完整便携版。中间隔着 11 个星期、132 个提交、201 个测试文件里的 1114 项测试。更早的两周（7 月 7 日起）其实已经在写竞品研究和单页向导设计规格了，但以 git 纪元论，这是完整的一生。这篇文章是复盘：为什么做、架构怎么定、踩了哪些坑、最后怎么在 macOS 上打出一个 Windows 包。</p>
<section><h2>一、为什么做这个系统<a href="#一为什么做这个系统"><span>#</span></a></h2><p>我们内容团队的日常是给商品做种草素材：一张产品图，要变成 16 秒的 Live 感视频，配上中文文案、价格角标、贴纸，发到小红书和抖音；还要追着平台上的爆款笔记做「手抄式图文」——模仿真实手写笔记的排版和语气做二创。这两件事的人工流程是这样的：运营自己想文案、开剪辑软件拉时间轴、逐字调整贴字位置；想做爆款二创，就把别人的笔记截图存下来，对照着一句句改。</p><p>每一条单看都不可怕，可怕的是量：一天几十条，每条都要重跑一遍「想文案 → 剪视频 → 排版」。而且文案改一个价格数字，视频就得重新导出一次。所以我决定做一套工具，把「策划文案、图片、视频、合成」全部模型化、流水线化，并且守住一条底线：<strong>用户只改文字的时候，绝对不重新调用视频模型</strong>——这条底线后来成了整个架构的锚点。</p></section>
<section><h2>二、系统全景<a href="#二系统全景"><span>#</span></a></h2><p>最终形态是一套 Next.js 16.3（App Router + standalone 产出）+ Prisma/SQLite + FFmpeg 的单体应用，生产构建生成 87 个页面/路由：</p><div><figure><figcaption></figcaption><pre><code><div><div><div>1</div></div><div><span>浏览器（Next.js 前端，创作工作台 / 爆款内容工作台 / 素材库 / 知识库）</span></div></div><div><div><div>2</div></div><div><span><span>   </span></span><span>│  /api/*（飞书 OAuth 会话，多租户隔离）</span></div></div><div><div><div>3</div></div><div><span><span>   </span></span><span>▼</span></div></div><div><div><div>4</div></div><div><span>Node 服务端（真实 Provider 只在这里被调用）</span></div></div><div><div><div>5</div></div><div><span><span>   </span></span><span>├─ LLMPlannerProvider ── gpt-5.6-terra：策划、文案、提示词、排版图层动效 JSON</span></div></div><div><div><div>6</div></div><div><span><span>   </span></span><span>├─ ImageProvider ────── gpt-image-2 系列：首帧图 / 参考图 / 图中文字替换</span></div></div><div><div><div>7</div></div><div><span><span>   </span></span><span>├─ VideoProvider ────── Seedance 2.0：只生成无字视频底片</span></div></div><div><div><div>8</div></div><div><span><span>   </span></span><span>├─ Compositor ───────── 本地 FFmpeg：底片 + 文案/价格/Logo/贴纸/评论框/箭头 → 成片</span></div></div><div><div><div>9</div></div><div><span><span>   </span></span><span>└─ AssetLibrary ─────── 一切上传与生成结果都落为 Asset（核心模块）</span></div></div></code></pre><div><div></div><div></div></div></figure></div><p>几个关键决策说清楚：</p><ul>
<li><strong>四大 Provider 抽象，边界写进项目宪法</strong>。<code>AGENTS.md</code> 里第一天就写死：Planner 只出 JSON、VideoProvider 只出无字底片、ImageProvider 只管图、Compositor 只管合成；文案、价格、Logo、贴纸、评论框、箭头一律是独立图层，后期合成。不允许任何业务代码写死某个平台名。真实 Provider 文件第一阶段只放 TODO，不许杜撰 endpoint 和请求体。</li>
<li><strong>本地默认 Mock，真实调用显式开启</strong>。所有付费调用前有费用确认（12 张图片的批次会明确告知），每次真实调用写 <code>ProviderUsageRecord</code>。API Key 只从服务端环境变量或 AES-256-GCM 加密配置读取，前端永远只见掩码。</li>
<li><strong>所有核心数据结构 TypeScript 类型 + Zod schema 双重契约</strong>。Planner 的输出 JSON、任务快照、画布图层全都要过 Zod，这是后面 1114 项测试的地基。</li>
<li><strong>测试是验收货币</strong>。从最初单页向导完成时的 20 项单元测试，一路涨到 7 月底的 684 项、8 月底的 1094 项，最终 201 个文件 / 1114 项。任何一个改动都要过全量 vitest + TypeScript + ESLint + 生产构建四道门。</li>
</ul><p>功能模块按使用频率排：两步创作工作台（素材 → 贴字/预览/发布文案 → 成片）、爆款内容中台（采集雷达 / 待审核 / 爆款库 / 内容池 / 成品项目 / 知识库 / 任务中心七个工作区）、沉浸式 AI 精修工作台（三栏：贴字与 IP 模板 / 3&lt;4&gt; 画布 / 图中文字与发布文案）、素材库与作品库、任务中心、系统设置，最后是两个分发形态：云端生产环境（一台云服务器，细节不展开）和 Windows 便携版。</p></section>
<section><h2>三、开发周期复盘<a href="#三开发周期复盘"><span>#</span></a></h2><p><strong>7 月上旬（07-07 ~ 07-21，git 纪元前）：文档先行 + 骨架。</strong> 第一天写的是竞品研究：ClipForge、Beav、几个 ComfyUI 对接项目逐个列出可借鉴点和不采用原因（AGPL/非商用的坚决不碰），结论是 <code>AssetLibrary + 四 Provider + JobService</code> 自建。然后是单页向导设计规格、实施计划，再是类型和 Zod schema、Prisma 模型、Mock Provider、API、页面、测试——这个顺序是 <code>AGENTS.md</code> 里定死的执行顺序，全程没破过例。</p><p><strong>7 月中旬（07-15 ~ 07-20）：创作工作台成型 + 飞书多租户。</strong> 产品图/场景图双输入、AI 候选图直选、作品库与素材库分家、公司自定义字体 FFmpeg 合成，阶段号一路刷到 8.21。同期把飞书 OAuth 接进来做了真正的多租户：全公司部门目录同步、一级部门展示、首次登录自动计费归属、Seedance 中转按部门路由、Image 2.0 公司统一定价。7 月 20 日做了一轮全项目审查与部署前加固。</p><p><strong>7 月下旬（07-28 ~ 07-29）：ChatGPT 收敛 + 第一版 Windows 便携包。</strong> 两天干了三件大事：文本链路从旧的 Ark 方案收敛到统一的 ChatGPT 文本 Provider（文本与图片共用一套公司公共加密 Key）；第二件是 Windows x64 便携版——随包带 Node、FFmpeg、Next.js standalone，员工解压双击 BAT 就能用，凭证 AES-256-GCM 加密、主密钥拆两半放不同目录，发行脚本扫描明文凭证、拒绝 <code>.env</code> 和数据库进 ZIP、在中文空格路径重新解压复验，第一版 261MB；第三件是生成可靠性：主动取消、Seedance 多图参考模式修正、异常任务五分钟规则 + 审计、ChatGPT 文本六类安全错误与有限重试、A1 自适应工作台。便携版 HTTP 回调读不到 OAuth state Cookie 的坑也是这天修的（本地 HTTP 不能带 <code>Secure</code>）。</p><p><strong>8 月上旬（08-06 ~ 08-08）：AI CTO 接管治理 + 安全升级。</strong> 项目当时本地领先远端 116 个提交、工作区一堆来历不明的文件，出了「单机故障全丢」的风险。8 月 6 日做了一次冻结基线接管：<code>PROJECT_STATE</code> / 证据册 / 健康报告 / Gate 全套建立，接管期业务代码修改授权为 NO，不自动 reset、clean、stash；先把 116 个提交推上远端解除单机风险，再以「协调式最小升级」把 next 从 16.2.10 升到 16.3.0（拒绝 <code>npm audit fix</code> 这种范围不可控的操作），清掉生产依赖里的 3 个 High。</p><p><strong>8 月中旬（08-10 ~ 08-18）：两步工作台 + 第一次整包替换发布。</strong> 两步创作向导、发布文案编辑器、抖音完整字段（旧建模只有 title，正文和话题标签压根没生成过）、React Strict Mode 草稿丢失、Mock 合成 <code>spawn ffmpeg ENOENT</code>（图形应用启动的进程不继承 shell PATH）都在这周修。8 月 18 日是里程碑日：图片模型逐个探针实测后切到可用的 <code>gpt-image-2-vip</code>（详见踩坑第 1 条）、修复图片「200 假成功」、采集器补上独立 HMAC 密钥、付费入口补数据库级幂等租约，然后本地完整版第一次以 <code>release-*-full-replacement</code> 整包替换方式发布到云端——从此每次发布都是：先备份可回滚快照、隔离目录装依赖构建核验、切换、健康检查、SQLite <code>integrity_check</code>。</p><p><strong>8 月 19 日 ~ 8 月 27 日：爆款中台九天冲刺。</strong> 这九天密度最大：小红书采集从 Chrome 扩展（两阶段：搜索候选 + 详情页补全，配对码换长期设备令牌）做到本地 CDP 执行器（只监听 127.0.0.1&lt;9222&gt;，只读已登录页面可见卡片，不碰 Cookie）；沉浸式 AI 精修工作台 v2 三栏重写；RAG 知识库（14 本书、3662 页、2438 个片段，FTS5 + sqlite-vec 1536 维混合检索）；手写风格提示词从 V5 迭代到 V21；逐页洗稿、动态画布模板、A/B/C 三种真人手写风格；「我的 IP / 封面模板」重构。期间 8 月 26 日用智能纪要加 32 分钟录音拆出 M01—M20 二十项改动清单，逐项修复逐项验收，光 8 月 26 日一天就发了 7 个 <code>release-*-full-replacement</code> 正式版。8 月 27 日做本地精简审计：包管理统一回 npm、工作区从 10GB 清到 1.6GB、删掉 50 条高耦合的 CSS 类名断言（这种测试会阻碍正常重构）。</p><p><strong>10 月 8 日：自配便携版，最后的冲刺。</strong> 新需求来了：安装包要上传到公司内部工具系统给外部用户下载，所以包里不能含任何公司凭证，用户在本机自配模型。一天之内做了 <code>self-config</code> 风味：免登录（首次访问自动创建本机用户）、「我的模型」配置页、凭证 AES-256-GCM 加密存本机 SQLite、密钥首次运行随机生成、未配置时生成接口返回 409 引导配置；模型名从固定枚举放开为非空字符串——这是对项目宪法「模型名固定」规则的<strong>经批准偏离</strong>，专门写了 ADR。同日在 macOS 上交叉打包出 223MB 的 Windows 包（详见踩坑第 6 条），中途还处理了一场 70 个文件被外部进程回退的事故（详见踩坑第 5 条）。</p></section>
<section><h2>四、踩坑实录：每一条都有日志佐证<a href="#四踩坑实录每一条都有日志佐证"><span>#</span></a></h2><section><h3>1. 图片生成「200 假成功」：最阴险的一类 bug<a href="#1-图片生成200-假成功最阴险的一类-bug"><span>#</span></a></h3><p>用户反馈「生成图片时没生成就停了」——没报错，也没出图。追 <code>/api/images/create</code> → 图片 Provider → 中转站全链路，生产日志里的记录是 <code>CHATGPT_IMAGE_RESPONSE_INVALID</code>、<code>httpStatus: 200</code>、<code>responseShape: 'keys=none;data0=undefined'</code>：中转偶发返回 HTTP 200 但响应体是空的。而 <code>handleRouteError</code> 的逻辑是 <code>httpStatus &lt; 500</code> 就透传，200 被当成成功一路放行，前端 <code>response.ok</code> 为真、忽略错误体、把候选图读成空数组。修复三件套：图片错误只透传上游 4xx（比如 429），2xx/5xx 一律落 502 杜绝假成功；错误文案区分「通道临时异常」；生成超时从 120 秒放宽到 180 秒（中转实测单张 40~80 秒，两张并行约 60 秒，120 秒太紧），后来又一次放宽到 360 秒——因为一条成功记录实际耗时 332 秒。配套纪律：<strong>HTTP 超时不能证明上游没计费，所以永远不自动重试付费生成请求</strong>，重试只能由用户主动发起；同 URL 的结果下载重试 3 次倒是安全的（覆盖超时/5xx/429，付费的生成 POST 仍只发一次）。</p><p>同一天还做了图片模型逐个探针：<code>gpt-image-2</code> 返回 502 或 200 空对象，<code>gpt-image-2-pro</code> 360 秒后空对象，<code>gpt-image-2-vip</code> 明确拒绝 <code>response_format</code> 参数——去掉后 40.5 秒返回可用图片。「接口列表里有这个模型」和「这个模型在这个账号分组里真的能用」是两回事，这一课和上一套投流系统里「接口存在不等于权限可用」一模一样。</p></section><section><h3>2. 保存竞态：SQLite 唯一索引允许很多个 NULL<a href="#2-保存竞态sqlite-唯一索引允许很多个-null"><span>#</span></a></h3><p>精修工作台同一来源首次进入时，React 开发模式双重加载并发调用项目初始化，而 <code>creationKey</code> 默认为空——SQLite 的唯一索引对 NULL 全部放行，于是同一用户、同一来源在 1ms 内创建了两个项目。接着 800ms 防抖保存只取消还没触发的定时器，拦不住已在途的 PATCH，两个请求带相同 revision，后完成者必然 409「保存冲突」。修复：默认项目用确定性创建键保证并发幂等；服务端 revision 校验改成数据库原子 compare-and-swap，堵掉「先读再写」的时间窗；前端保存抽成串行协调器。同一个bug家族还有：撤销/重做没清掉未触发的自动保存定时器导致撤销结果被旧快照覆盖；<code>pointermove</code> 每次都压历史导致一次拖动手势产生几十份像素级差异快照、点撤销像没反应——改成手势开始只记一次完整前态。后来干脆按用户要求移除了防抖，编辑即存。</p></section><section><h3>3. 数据迁移把用户的 6 页项目重建成 1 页<a href="#3-数据迁移把用户的-6-页项目重建成-1-页"><span>#</span></a></h3><p>一次发布后的强制刷新验收发现，<code>init-db.mjs</code> 的历史来源页迁移没排除空白创作项目，启动时把一个 6 页项目错建成 1 页。处理过程成了之后所有迁移的模板：先离开在线编辑页避免二次写入，另存数据库快照，再从发布前的 SQLite 备份把这个项目精确恢复到 revision 1141、6 页、原第 6 页选中；迁移代码明确跳过空白与无来源项目，并补一条「重复启动保持空白项目 6 页不变」的真实 SQLite 回归。另一个数据事故：初始化脚本每次启动强插两个命名 IP 模板，其中一个还挂着已不存在的 Asset 变成灰色坏卡片——确认零引用后从开发库删掉，备份先行。</p></section><section><h3>4. 「打开原帖」失效：安全参数被自己剥掉了<a href="#4-打开原帖失效安全参数被自己剥掉了"><span>#</span></a></h3><p>内容池的「打开原帖」进入 <code>error_code=300031</code> 失效页。定位发现是自己的代码干的：采集执行器和 Chrome 扩展在详情页用 <code>location.href.split("?")[0]</code> 清理 URL，把小红书需要的 <code>xsec_token</code> / <code>xsec_source</code> 删了。修复后两条采集路径都优先保留当前地址的安全参数，页面没带令牌就用搜索候选提供的带令牌地址，并从历史搜索快照恢复了那条记录的链接（改前备份了数据库）。</p></section><section><h3>5. 70 个文件被外部进程回退：从 git 对象里把工作「捞」回来<a href="#5-70-个文件被外部进程回退从-git-对象里把工作捞回来"><span>#</span></a></h3><p>10 月 8 日做自配便携版时，测试突然大面积莫名失败。排查发现工作区约 70 个源码文件被某个外部进程（疑似同时开着的其他编辑器或同步工具）在中途逐步回退成旧版本，而部分新功能（IP 素材、我的 IP、任务暂停恢复）当时只存在于 git 暂存区对象里；更糟的是我先做的 <code>git stash</code> 验证实验把损坏状态固化了一层。恢复方法：<code>git fsck --lost-found</code> 找出 dangling commit（stash 产生的 index 快照和工作区快照），逐文件比对、<strong>两个快照取并集</strong>合并——比如服务文件里合入 <code>pause/resume</code> 方法、模板 schema 补回新增字段——最后全量 vitest 201 文件 / 1114 项全绿收尾。这次之后立了两条规矩：大批量改动前后先 <code>git add</code> 建保护点；测试莫名从通过变失败，第一反应先怀疑文件被外部改了，而不是怀疑测试。</p></section><section><h3>6. 在 macOS 上交叉打包 Windows：中文文件名乱码逼我写了个 ZIP 写入器<a href="#6-在-macos-上交叉打包-windows中文文件名乱码逼我写了个-zip-写入器"><span>#</span></a></h3><p>最后一公里全是工程细节。<code>prisma/schema.prisma</code> 固定 <code>binaryTargets=["native","windows"]</code> 让一份代码带两份查询引擎；<code>npm i --no-save --force</code> 注入 win32 的 FFmpeg/FFprobe 安装包和 sqlite-vec，因为 <code>@ffmpeg-installer/ffmpeg</code> 在模块加载时就 require 平台包，缺了直接崩；再下载与本机版本一致的 Windows <code>node.exe</code>（v24.19.0）。打包器把 win32 原生件注入 standalone 的 node_modules、剪掉 darwin 件。最坑的是压缩：macOS 系统的 <code>zip</code> 和 <code>ditto</code> 都不给中文文件名写 UTF-8（EFS）标志，中文 Windows 解压必乱码——最后写了个纯 Node 的 ZIP 写入器专门处理 EFS 标志，而 macOS 自带的 unzip 6.0 又不认 EFS，校验解压改用 <code>ditto -x -k</code>。产物 <code>AI种草Live-0.1.0-186d2d6-win-x64.zip</code>：223MB、3573 个文件，打包器内置全量哈希解压复验，自配风味的校验规则反过来要求<strong>凭证文件必须不存在</strong>。唯一没能闭环的是 Mac 无法执行 PE，Windows 真机双击验收留给了用户。</p></section><section><h3>7. 取消一个生成，比生成本身难<a href="#7-取消一个生成比生成本身难"><span>#</span></a></h3><p>「停止生成」要贯穿全栈才算数：前端统一的可取消 AI 操作控制器（页面卸载自动中断、取消后不应用迟到结果），<code>AbortSignal</code> 从 Route Handler 一路传进 Planner、图片 Provider、OCR Provider 和文案服务，Provider 返回后、<strong>落库前</strong>再检查一次取消状态——不然用户停了，结果又写回去了。视频后台任务走另一条持久化取消链路：优先请求原通道取消，通道不支持就如实告知「供应商任务可能仍在运行」，绝不自动重新付费提交。<code>pending/planning</code> 超过 5 分钟没有 Provider 任务号判定为「等待异常」，提供检查状态 / 终止 / 返回草稿，每次操作写不可变审计。</p></section></section>
<section><h2>五、「无字底片 + 后期合成」与真人手写的执念<a href="#五无字底片--后期合成与真人手写的执念"><span>#</span></a></h2><p>这两个是整个系统最值得单独讲的设计。</p><p><strong>无字底片。</strong> Seedance 2.0 永远只生成无字视频底片，中文文案、价格、Logo、贴纸、评论框、箭头全部是独立图层，由 FFmpeg Compositor 后期合成。直接动机是视频模型写不好中文，但真正的回报是经济性：用户改一个价格数字、挪一下贴字位置、换个 Logo——只重新合成，几秒出结果，视频模型一次都不用再调。配套的省钱设计还有：成片 16/27 秒里动态段只占 1~16 秒可配，静止尾段是提前截取的清晰关键帧拉长（「Live 感柔化收尾」用 FFmpeg <code>blend</code> 时间表达式做 0.25 秒柔化再回到清晰帧，零模型费用）；发布文案在视频任务创建后立即并行生成，不等成片，也绝不会重复触发视频调用。二创三版批量走数据库租约 + 逐卡检查点，失败重试只补缺失的图片，重复请求零 Planner 调用。</p><p><strong>真人手写。</strong> 手抄式图文要的是「像真人写的」。这条路走了四个阶段，方向绕了整整一圈：最早想用 CSS 手写字体伪造——否，一眼假；第二阶段写了 <code>CanvasHandwritingRenderer</code>，用 @napi-rs/canvas 按字符做确定性扰动（旋转、基线、字宽、墨色、行倾斜，种子可重放），默认打包 SIL OFL 的霞鹜文楷——解决了重放和稳定，但本质还是字体渲染；第三阶段转向提示词工程，一天之内从 V5 迭代到 V18：纸纤维微压痕、笔压可见、掠射光、凹槽积墨、行草基线……每一版都在逼近真实，但也每一版都在「教模型表演手写」；最后在 V21 和 8 月 27 日的终版上想通了——<strong>别伪造，用真实样本</strong>。终版方案：A「清晰自然」/ B「日常随写」/ C「松弛连写」三档，弹窗里展示的全是本租户真实抓取、已完成 OCR 的笔记图片，配一个确定性的字迹摘要分类器（「潦草/连写/行草」归 C，「工整/楷写」归 A），用户必须亲自挑一张真实参考图；生成时 <code>editImageText</code> 带两张参考——第一张锁定当前页背景与文字区域，第二张只约束笔画动作、笔压、墨色、连写习惯，明确禁止复制样本内容。图片模型调用次数不增加，真实感却发生了质变。绕了一圈回到「数据比提示词诚实」，这是本项目我最认的一个产品结论。</p></section>
<section><h2>六、效果<a href="#六效果"><span>#</span></a></h2><p>11 周后交付了什么：</p><ul>
<li>一个生产系统：云端多租户部署 + Windows 便携版双形态。创作链路（素材 → 策划 → 无字底片 → 合成 → 发布文案）全程服务端 Provider，前端零凭证。</li>
<li>87 个页面/路由的生产构建、201 个测试文件 / 1114 项测试全绿；生产构建从 37 个路由长到 87 个。</li>
<li>8 月 18 日到 27 日十天里十几次 <code>release-*-full-replacement</code> 整包替换发布，每次带发布前备份与回滚快照；期间最严重的一次线上事故——启动迁移把用户 6 页项目误重建为 1 页——也是先另存快照、再从发布前 SQLite 备份精确恢复到 revision 1141，没有丢过用户数据。</li>
<li>爆款采集链路：Chrome/Edge 扩展 + 本地 CDP 执行器，两阶段采集（搜索候选 + 详情补全），图片走 HTTPS 主机白名单 + MIME + 魔数校验后落私有 Asset（<code>moduleScope</code> 隔离，不污染通用素材库）；RAG 知识库 14 本书 / 3662 页 / 2438 片段，FTS5 + sqlite-vec 混合检索。</li>
<li>便携版从 261MB 共享凭证版进化到 223MB 自配版：包内零凭证（打包校验强制）、免登录、用户模型配置 AES-256-GCM 加密只存本机，敏感信息规则扫描在 tracked 文件与全部 git 历史中 0 命中。</li>
<li>给运营省下的真金白银：改文案/贴纸零视频成本重合成、批量二创失败只补缺失图片、付费前强制确认 + 每次调用记账、超时永不自动重试付费请求。</li>
</ul></section>
<section><h2>七、反思与后续<a href="#七反思与后续"><span>#</span></a></h2><p><strong>做对了的</strong>：文档先行且执行顺序写进宪法、四大 Provider 边界第一天定死（后期所有「只改文字不重新生成」的收益都源于此）、Mock 默认 + 付费显式确认、Zod 与 TypeScript 双契约让 1114 项测试有了着力点、发布永远先备份、迁移永远幂等且跳过不该碰的项目。7 月 21 日第一个 commit 里就有 <code>AGENTS.md</code>，这份项目宪法让 AI 协作开发 11 周没有跑偏过边界。</p><p><strong>没做好的</strong>：无标准数据库 migration，schema 靠 Prisma 与手写 DDL 幂等初始化共同维护，升级漂移风险一直挂着；8 月 19 日到 27 日九天冲刺密度太大，23 号一天修了七个 bug 说明前面的验收债欠了；git 提交在 8 月 18 日后基本停滞、大量成果长期躺在暂存区——10 月 8 日那场 70 文件回退事故之所以惊险，根源就是「工作只存在一个地方」；Turbopack 构建在本机因 PostCSS 子进程端口权限长期失败，靠 Webpack 兜底，始终没根治。</p><p><strong>后续方向</strong>：Windows 真机双击验收和上架内部工具系统是眼前的事；数据库 migration 基线化必须排上；三风格手写的视觉终验还在等真实双用户浏览器隔离测试。以及一条留给自己的原则，跟上一套系统收尾时写的是同一句：<strong>宁可不动，也不乱动；宁可备份多余，也不信任单一副本。</strong></p></section>]]></content>
    </entry>
    <entry>
      <id>https://liqiming.top/posts/qianchuan-ai-ad-system/</id>
      <title type="text">一个月从零到生产：我做了一套对接巨量引擎的千川 AI 投流系统，这些坑都是真金白银换来的</title>
      <published>2026-10-07T00:00:00.000Z</published>
      <updated>2026-10-07T00:00:00.000Z</updated>
      <author><name>图明</name></author>
      <link rel="alternate" href="https://liqiming.top/posts/qianchuan-ai-ad-system/"/>
      <summary type="text">复盘一个月开发周期：多账户授权、追投、直播大屏、评价管理到 AI 调价引擎，8 个实测踩坑与「规则只做约束、判断归 AI」的架构决策。</summary>
      <content type="html"><![CDATA[<p>9 月 8 日下午我在 package-lock.json 里敲下第一行依赖，10 月 7 日上午最后一次构建产物落进 dist/。整整一个月，一套对接巨量引擎（千川）开放平台的投放管理与调控系统，从空目录跑到了生产环境，服务真实的投放团队。这篇文章是完整复盘：为什么做、怎么搭、踩了哪些坑、AI 调价引擎为什么这么设计。</p>
<section><h2>一、为什么做这个系统<a href="#一为什么做这个系统"><span>#</span></a></h2><p>我们是有直播电商投放团队的品牌方。投手的日常是这样的：几十个千川广告主账户散落在后台，看数据要挨个切；一场直播爆了，好素材要手动建追投任务；ROI 目标靠人在大屏前盯，每十五分钟看一眼消耗和成交，高了调低、低了调高；评论区的问题分散在各个抖音号下面，想按号归拢只能靠平台后台慢慢翻。</p><p>每一件事单看都不难，难的是「持续、及时、不出错」。人盯盘有两个致命问题：一是半夜盯不动，二是情绪化——数据一抖就手抖。所以我决定做一套系统把这些流程接进来：多账户 OAuth 授权管理、计划总览、素材追投、直播大屏、评价（评论）管理，最后加一个 AI 调价引擎，让「加多少减多少」这件事交给数据和模型判断。</p></section>
<section><h2>二、系统全景<a href="#二系统全景"><span>#</span></a></h2><p>上线后的形态（nginx + systemd 部署在一台云服务器上，域名就不公开了）：</p><div><figure><figcaption></figcaption><pre><code><div><div><div>1</div></div><div><span>浏览器（React 19 + Vite 8 单页应用，dist/ 静态产物）</span></div></div><div><div><div>2</div></div><div><span><span>   </span></span><span>│  /api/* 反向代理</span></div></div><div><div><div>3</div></div><div><span><span>   </span></span><span>▼</span></div></div><div><div><div>4</div></div><div><span>Node 服务（127.0.0.1:8787，纯 Node 内置模块，无 Express）</span></div></div><div><div><div>5</div></div><div><span><span>   </span></span><span>│  Access-Token 鉴权 + 频控退避</span></div></div><div><div><div>6</div></div><div><span><span>   </span></span><span>▼</span></div></div><div><div><div>7</div></div><div><span>巨量引擎开放平台（OAuth / 全域计划 / 调控任务 / 素材 / 评论 / 直播大屏 / 报表）</span></div></div></code></pre><div><div></div><div></div></div></figure></div><p>几个关键的技术选型说清楚：</p><ul>
<li><strong>后端零依赖</strong>。<code>server/index.mjs</code> 用 <code>node:http</code> 手写路由，一共几十个 API 路由，好处是生产服务器上连 <code>npm install</code> 都不用跑，rsync 上去重启 systemd 就完事。平台客户端独立在 <code>server/oceanengine.mjs</code>，AI 顾问在 <code>server/ai-advisor.mjs</code>。</li>
<li><strong>前端不引组件库</strong>。React 19 + Vite 8，图标用 lucide-react，样式全部手写。整个前端几乎是两个大文件：<code>src/main.jsx</code>（约 54 万字符）和 <code>src/styles.css</code>。不体面，但一个月工期里这是最快收敛的方式。</li>
<li><strong>共享契约层 <code>shared/</code></strong>。调价决策核 <code>bid-engine.mjs</code> 是纯函数、无 IO、无依赖，Node 内置 test runner 直接跑 48 个用例。</li>
<li><strong>数据存储是 JSON 文件</strong>（<code>server/data/</code> 下的 <code>oauth-grants.json</code>、<code>plans.json</code>、<code>audit-events.json</code>、<code>bid-bindings.json</code> 等）。没有数据库。对一个单团队内部系统，文件 + 原子写 + 启动恢复够用，而且备份就是 cp。</li>
<li><strong>测试是验收货币</strong>：<code>npm run test:contracts</code>（48 项契约测试）+ smoke + domain + build，后来又加了 48 项引擎纯函数测试和 21 项引擎服务端回环测试（用本地 mock 平台 <code>scripts/local-e2e-mock.mjs</code> 挡住真实外呼）。</li>
</ul><p>功能模块（侧栏即产品）：账户授权管理、账户中控台、全域计划总览（行内补预算/调 ROI）、素材调控管理（素材列表 + 追投 + 调控任务）、批量创建计划（本地草稿）、AI 直播调价策略、评价管理、操作日志、系统管理（真实写入总开关、AI 模型配置）。</p><p>安全边界是第一天就定下的（项目根 <code>AGENTS.md</code>）：默认全只读；真实写操作（补预算/调 ROI/追投/回复评论）必须过「总开关 + 稳定幂等键 + 写入台账（SUBMITTING→RESPONDED 状态机）+ 审计 + 提交后自动回读核验」五道门；删除类平台操作在任何情况下拒绝（调控任务状态接口的 DELETE 枚举在服务端直接拦掉）。</p></section>
<section><h2>三、开发周期复盘<a href="#三开发周期复盘"><span>#</span></a></h2><p><strong>9 月上旬（9-08 ~ 9-13）：文档先行 + 对齐操作习惯。</strong> 第一天先写的不是代码，是 <code>docs/PRODUCT_SPEC.md</code>、<code>DEVELOPMENT_PLAN.md</code>、<code>REUSE_STRATEGY.md</code>。9-11 组装了 <code>docs/ad-system/</code> 文档包：48 项功能逐项规格、48 个候选接口映射、64 条验收用例、21 个待核验问题。接口映射表里每个接口都标了核验深度（ENDPOINT_ONLY / PARAMETER_PARTIAL / SDK_VERIFIED），「接口存在」不等于「权限可用」，这句话后来救了我很多次。9-12~9-13 对照在用的老系统（飞流智投）逐页对齐交互——计划总览的筛选结构、27 列宽表、「+/准星」行内按钮的语义，都用无头浏览器截图核过。9-13 打通真实 OAuth：授权回调返回 ok，工作台账户接口展开出 68 个千川业务账户，<code>uni_promotion/list/</code> 读到第一条真实直播全域计划。</p><p><strong>9 月中旬（9-14 ~ 9-18）：读取链路工程化。</strong> 68 个账户 × 4 个场景 = 272 次只读请求，最初在浏览器里串行发，频繁撞 40100 频控。9-15 写了 <code>docs/PLAN_READ_DESIGN.md</code>，把读取搬到服务端持久化任务队列（<code>plan-read-jobs.json</code>）：全局限速、指数退避（60s/120s/300s）、断点恢复、重启不重读。9-16 动策略模块前先做了全量备份（<code>_backup_pre_fix_20260916/</code>，连 <code>server/data/*.json</code> 都记了 MD5），9-17 调整环境配置（留了 <code>.env.bak-20260917163059</code>），9-18 契约测试扩到 48 项全绿。</p><p><strong>9 月下旬（9-19 ~ 9-23）：写链路与素材/评论模块。</strong> 9-19 接操作员登录（<code>operator-auth.mjs</code>，公网部署关闭自助注册）和评论只读接口；9-22 素材调控模块重构，重构前又做了一次带 SHA256SUMS 的全量备份（<code>_backup_material_module_20260922_143636/</code>，含恢复演练步骤）；同一天对着官方 Go SDK 逐字段核验素材/调控任务契约，9-23 直接在千川后台实测追投弹窗，拼出「视频追投与直播间画面追投是同一接口的两种对象」这个关键认知。</p><p><strong>10 月上旬（10-03 ~ 10-07）：AI 调价引擎与评价管理冲刺。</strong> 10-03 核验直播大屏三件套接口并上线大屏视图；10-04 写部署文档、AI 评审接入做成页面在线配置；10-05 定下「规则只做约束、判断归 AI」的架构（这天下深夜还出过一次误删文件事故，后面细说）；10-06 白天给 AI 调价加「数据门」修振荡、完成 ROI 口径代数实证，晚上评价管理模块部署生产、真数据自验通过；10-07 上午还在迭代前端。</p></section>
<section><h2>四、踩坑实录：每一条都有代码佐证<a href="#四踩坑实录每一条都有代码佐证"><span>#</span></a></h2><section><h3>1. 追投接口的实测契约——平台的回显不能照抄进创建请求<a href="#1-追投接口的实测契约平台的回显不能照抄进创建请求"><span>#</span></a></h3><p>素材追投走 <code>uni_promotion/ad/control_task/create/</code>。这个接口我前后失败了 21 次才拼出完整契约（台账里 21 次创建失败全是参数问题）：</p><ul>
<li><strong>预算</strong>：必须是 100 的整数倍，且不超过原计划预算的 50%（2026-09-24 实测定论，前端校验文案里就写着这两条）。</li>
<li><strong>duration（控成本追投）</strong>：任务回显里 duration 是 87672（约十年，等于「长期有效」），但你创建时传 87672 会被 schema 拒（“must be most 24”），传自定义值又被语义拒（「不支持自定义时长」）——正确做法是<strong>完全不传</strong>，平台自动落默认。放量追投才传 0.5~24 小时、0.5 步进。</li>
<li><strong>audience（定向人群）</strong>：回显是全 null 的完整对象，但创建时数组型键不接受 null（平台报 “Value is not nullable”）——正确做法是把值为 null 的键整个去掉，没设置定向就传空对象 <code>{}</code>。读取侧的形态不能照抄进写入侧，这是这次学到的最反直觉的一课。</li>
<li><strong>400154 排查</strong>：平台只回笼统的 400154「请求参数设置错误」，不指名字段。我的办法是给每个写入请求落一份截断的请求体快照进台账，事后能对照；后来定位到一次 400154 的真实原因是把直播间画面素材 ID 塞进了 <code>material_ids</code> 却没带 <code>material_type</code>，平台按视频素材查这个 ID 查不到。画面追投要走独立的 <code>room_material_id</code> 字段，单一固定目标，不能和视频混投。</li>
<li><strong>SYSTEM_DISABLE 是常态</strong>：全域直播计划未开播时常驻「系统暂停」状态。早期我把它当「平台可能拒单」的预警条件，属于错误归因——修正参数后，同状态计划连续 12 次创建成功。所以现在只对真正的终态（已删除/已冻结/余额、预算下线）提示，常规暂停态不拦。</li>
<li><strong>19 位 ID 精度</strong>：素材/任务/评论 ID 是 19 位整数，超出 JS 安全整数范围，<code>Number()</code> 一转末位就舍入——追投会打到另一个素材上。读路径在 JSON.parse 前对长整数做正则引号化保真；写路径用哨兵法：序列化时先包 <code>@@id@@</code> 再正则还原成裸数字。</li>
</ul></section><section><h3>2. 直播大屏接口：fields 必填、时间必须带秒<a href="#2-直播大屏接口fields-必填时间必须带秒"><span>#</span></a></h3><p><code>today_live/room/get</code> 必须带 <code>advertiser_id + aweme_id + date_time</code>（北京日期），fields 是 JSON 数组查询参数；<code>today_live/room/product_list/get</code> 的 fields 同样必填且 productId 是驼峰；<code>report/live/get</code> 的 start_time/end_time 必须是 <code>yyyy-MM-dd HH:mm:ss</code> 带秒格式。少了 fields 或只传到日期位，接口直接报参数错误。这些是 10-03 拿线上凭证逐个直调核验后写进 <code>oceanengine.mjs</code> 注释的。</p></section><section><h3>3. 考核 ROI 的口径是算出来的，不是读出来的<a href="#3-考核-roi-的口径是算出来的不是读出来的"><span>#</span></a></h3><p>页面上有好几个 ROI 字段，到底哪个和 roi2_goal 同口径？我用一个生产计划做了代数实证：平台返回考核 ROI 2.06，当日含券成交 4881、消耗 2367.49，4881 ÷ 2367.49 = 2.062，吻合；换实付口径算是 1.377，不吻合；<code>stat_cost_for_overall_roi2</code> 字段恒为 0，不可用。结论：<strong>考核 ROI = 含券 GMV ÷ stat_cost</strong>（对应平台字段 <code>total_prepay_and_pay_order_roi2</code>，分子用 <code>total_pay_order_gmv_include_coupon_for_roi2</code>）。这条口径后来直接写进了 AI 提示词和引擎数据门，是整个调价引擎的度量基石。</p></section><section><h3>4. 评论归属：反查接口有上限，第 11 个抖音号被截掉了<a href="#4-评论归属反查接口有上限第-11-个抖音号被截掉了"><span>#</span></a></h3><p>评价管理要做「每条评论归属到哪个授权抖音号」。平台评论接口 <code>tools/comment/get</code> 没有「视频归属抖音号」字段；<code>aweme/video/get</code> 和 <code>tools/aweme_auth_list/</code> 实测都返回 40002「advertiser does not grant you permission」，此路不通。实测可用的路径是：<code>tools/comment/get</code> 的 <code>filtering={"author_ids":[数字uid]}</code> 支持<strong>按视频作者抖音 id 过滤</strong>，且账号间评论天然隔离——某账号能扫到的 item_id 就归属该账号。于是反查变成「逐授权号带 author_ids 扫评论建映射」。</p><p>两个细节坑：一是 author_ids 必须传<strong>数字 uid</strong>，超出 JS 安全整数范围的 uid 我宁可 422 拒绝（错误码 <code>AWEME_ID_INVALID</code>）也不能四舍五入后扫错账号——那等于把归属安到别人头上，是伪造数据；二是反查有预算上限，最初只扫前 10 个授权号，10-06 生产上授权号涨到 11 个，第 11 个号（某位主播）的评论归属恒为空，用户报「抖音号·本账号列全是空的」。根因就是这个 10 的上限把人截掉了。修复：上限放宽到 20、时间预算放宽到 20 秒、逐号 250ms 错峰。当晚生产真数据自验：20 个授权号、20/20 条评论全部归属成功。另外审计日志的实现是新记录 <code>unshift</code> 插在数组头，最新事件永远在第一位，和界面上「最新在前」的直觉一致。</p></section><section><h3>5. OAuth token 自动刷新<a href="#5-oauth-token-自动刷新"><span>#</span></a></h3><p>access_token 有效期 24 小时，不能让人每天重新授权。实现是 <code>ensureAccessToken</code>：过期前 5 分钟自动轮换；用 Promise 单飞防止并发请求同时刷；平台轮换 refresh_token 后立即把新 token 对落盘回 grants 文件，否则下次重启就丢刷新链；重启恢复时 accessToken 为空，按用过的 refresh_token 反查同一条授权补写。服务重启不掉线，这条在生产跑了三周没出过事。</p></section><section><h3>6. 部署工程化：rsync 要护住 data/<a href="#6-部署工程化rsync-要护住-data"><span>#</span></a></h3><p>部署流程写在 <code>DEPLOY_SERVER.md</code>：本地 <code>VITE_API_BASE=&lt;生产域名&gt; npm run build</code>，前端产物先 rsync 到服务器 <code>/tmp/dist-new/</code> 暂存，再 sudo rsync 进 nginx 静态目录并 chown www-data；后端只同步 <code>server/ shared/</code>，<strong>必须加 <code>--exclude data/</code></strong>——<code>server/data/</code> 里有线上真实授权凭证与快照，一次手滑同步就等于覆盖生产授权。动任何东西之前先做带校验和的全量备份（9-16 那次连数据文件记的是 MD5，9-22 那次是 SHA256SUMS，都留了恢复演练命令）。CORS 默认只放行 <code>127.0.0.1:5173/4173</code> 这几个开发端口，线上站点通过 <code>ALLOWED_ORIGIN</code> 显式指定。还有一个反直觉的点：systemd 服务<strong>不能设</strong> <code>NODE_ENV=production</code>——代码里的租户熔断会在这种状态下把所有业务接口 503 掉，线上安全靠的是登录门禁 + 关闭自助注册，和本地同构。</p></section><section><h3>7. AI 调价引擎：建议振荡与数据门<a href="#7-ai-调价引擎建议振荡与数据门"><span>#</span></a></h3><p>这个单独立一节讲，因为它是整个系统最有意思的部分。</p></section></section>
<section><h2>五、AI 调价引擎：「规则只做约束、判断归 AI」<a href="#五ai-调价引擎规则只做约束判断归-ai"><span>#</span></a></h2><section><h3>架构决策的来龙去脉<a href="#架构决策的来龙去脉"><span>#</span></a></h3><p>最早的引擎是纯规则的：实际 ROI 高于目标就降标放量、低于目标就升标收紧，固定 15% 步长。跑起来发现规则引擎有个天花板——它只会看「偏差方向」，不会看「量级和节奏」。偏差 12% 和偏差 40% 用同一个步长，消耗在萎缩和消耗在爆发用同一个动作，这不叫调控，叫条件反射。</p><p>10-05 深夜我定下架构：<strong>规则只做约束，判断归 AI</strong>。规则层保留全部硬约束——目标上下限、单次幅度、15 分钟节流、每日 8 次上限、日累计幅度 40% 封顶、观察期、熔断；「加多少减多少」由 AI 每轮拿整场直播数据判断，输出 <code>{action, suggestedRoiTarget, risk, note}</code> 的严格 JSON。AI 的提议回来还要再过一遍服务端硬约束（clamp 到上下限、升标 ≤5%、降标 ≤20%，超限自动收敛不拒绝）。</p><p>配套的安全策略是：<strong>AI 欠费、超时或未配置时，不产出任何 RAISE/LOWER 建议</strong>——引擎的跳过计数器记 <code>SKIP_AI_NOT_CONFIGURED</code>，数据照读、审计照记、熔断保护（PAUSE_SUGGEST）照常，但宁可不动也不乱动。规则引擎的原始决策不再作为建议输出（启动时还会清理历史纯规则遗留建议）。唯一例外是熔断：连续烧钱零成交（自上次出单花费 ≥ 3 × 推导成交成本）时的暂停建议保留，因为这是保护性止血，不是调价判断。</p></section><section><h3>数据门：修掉建议振荡<a href="#数据门修掉建议振荡"><span>#</span></a></h3><p>AI 上线第一晚就暴露新问题：小样本窗口的 ROI 剧烈虚高——一个 15 分钟窗口只有 1 单、几块钱消耗，ROI 能飙到 15+，AI 一看「远超目标」就建议降标，下一个窗口数据回落又建议升标，<strong>两小时 5 次反转</strong>。</p><p>10-06 加了两道数据充分性硬约束（在 <code>mergeAiAdvice</code> 里，AI 提议也必须过）：</p><ul>
<li><strong>门 D1 累计死区</strong>：主口径改为「当日累计考核 ROI」（优先平台返回值），距目标偏差不足 ±10% 直接 HOLD——短窗口波动不构成调价理由；</li>
<li><strong>门 D2 降标样本门</strong>：LOWER（降标放量）要求最近窗口成交 ≥3 单，样本不足不许降。</li>
</ul><p>同时给 AI 的上下文做了两件事：一是<strong>所有比率引擎先算好</strong>，不让模型自己做除法（它会算错，而且不可复现）；二是<strong>口径写进字段名</strong>——<code>当日累计_考核口径</code>、<code>前15分钟窗口_引擎估算</code>、<code>本场直播实时_大屏支付口径</code>，提示词里明确「窗口成交单数 &lt;3 时不得作为下调目标的依据」「大屏支付口径天然低于考核口径，仅作参照」。修完之后振荡消失，建议节奏稳定在「调一次→观察四个窗口→再评估」。</p></section><section><h3>两个生产细节<a href="#两个生产细节"><span>#</span></a></h3><p><strong>模型延迟</strong>：生产接的是火山方舟 doubao-seed 系列，默认开深度思考，一次判断 25 秒起步，超出引擎等待窗口。实测给请求体加 <code>thinking:{type:"disabled"}</code> 后 1~2 秒返回且质量不受影响——现在代码里对 doubao-seed 前缀的模型自动带这个参数。Key 存 <code>ai-config.json</code>（0600 权限，页面只回显掩码），页面保存即时生效不用重启。</p><p><strong>误删事故与恢复</strong>：10-05 定架构那晚，我在重构引擎代码时误删了文件——好在编辑器的文件状态快照（readFileState）里存着被删文件的内容，从快照里把代码恢复了出来，损失了半小时而不是一晚上。这次之后我给「大改先全量备份」这条纪律又加了一层保险，也顺手把备份目录的恢复演练写成了文档。</p></section><section><h3>交互形态<a href="#交互形态"><span>#</span></a></h3><p>绑定流程做成向导（账户→计划→参数），绑定后进入计划列表页（状态筛选 + 搜索 + 详情钻取），每个计划有独立详情页：建议卡显示当前目标/建议目标/目标区间/AI 判断与理由（AI 原提议和硬约束收敛后的采纳值不一致时会标注「已按上下限/幅度约束收敛」）。计划列表专门加了「<strong>实际 ROI</strong>」列，展示的就是第三节实证出来的考核口径，旁边才是出价目标 ROI——投手一眼能分清「跑出来的」和「设进去的」。</p></section></section>
<section><h2>六、效果<a href="#六效果"><span>#</span></a></h2><p>一个月后回头看交付了什么：</p><ul>
<li>一个生产系统：多账户 OAuth（token 自动轮换不掉线）、全域计划总览（行内补预算/调 ROI 真实写）、素材追投（幂等 + 台账 + 回读核验）、直播大屏、批量创建（本地草稿），前端 48 项 + 引擎 48 + 21 项测试全绿。</li>
<li>评价管理 10-06 上线当晚真数据自验通过，20 个授权号评论 20/20 全部归属成功。</li>
<li>AI 调价引擎在「判断归 AI + 数据门」架构下振荡消失，危险动作层层设卡：AI 高危否决（<code>AI_VETOED_HIGH_RISK</code>）不自动执行、写入后回读不匹配自动冻结该计划、调价后连续 3 轮 ROI 偏差恶化自动暂停当日执行。</li>
<li>最值钱的资产其实是那套契约知识：48 个接口的核验深度标注、追投创建的「回显镜像」契约、ROI 口径实证——这些是用真实的 21 次失败换来的，全部固化在代码注释和 <code>docs/</code> 里。</li>
</ul></section>
<section><h2>七、反思与后续<a href="#七反思与后续"><span>#</span></a></h2><p><strong>做对了的</strong>：文档先行、核验深度分级（「接口存在」永远不等于「权限可用」）、默认只读 + 写入门禁链、大改前全量备份、决策核纯函数化。这五条让我在一个月里没有出过一次真实资金事故。</p><p><strong>没做好的</strong>：单体文件太大了，<code>index.mjs</code> 43 万字符、<code>main.jsx</code> 54 万字符，接下来的第一件事就是按模块拆分；JSON 文件存储在多实例场景会到瓶颈，迁移 PostgreSQL 的设计文档其实早就写了，一直没排上；追投编辑接口对 duration 的语义（update 支持 1.5~24 小时）和 create 不同，这块的用户提示还不够直白。</p><p><strong>后续方向</strong>：把 AI 判断的离线回测跑起来，用历史直播数据对比「AI 调价 vs 人工调价」的 GMV 和利润差；素材侧接上高潜识别，让追投建议也从「人挑」变成「数据挑」；再往后是托管策略的完整闭环——但每一步都会继续守着那条红线：宁可不动，也不乱动。</p></section>]]></content>
    </entry>
    <entry>
      <id>https://liqiming.top/posts/ai-news-2026-10/</id>
      <title type="text">2026 年 10 月 AI 圈：Gemini 4 Argon 掀桌，OpenAI 卖「AI 员工」，Claude 开始参与写 Claude</title>
      <published>2026-10-03T00:00:00.000Z</published>
      <updated>2026-10-03T00:00:00.000Z</updated>
      <author><name>图明</name></author>
      <link rel="alternate" href="https://liqiming.top/posts/ai-news-2026-10/"/>
      <summary type="text">国庆前后这一周多，谷歌、OpenAI、Anthropic 接连出牌：Gemini 4 Argon 冲击真实软件工程纪录，DevDay 把 ChatGPT 改造成智能体平台，Claude 已主导自家 26% 的模型研发；国内云栖大会亮出算力三倍的真武 V900。</summary>
      <content type="html"><![CDATA[<p>9 月那篇月报刚发完半个月，AI 圈又把牌桌掀了一遍。谷歌沉寂半年后放出 <strong>Gemini 4 Argon</strong>，OpenAI 在 DevDay 上把 ChatGPT 正式改造成<strong>智能体平台</strong>，Anthropic 则公布了一个很微妙的数字——<strong>Claude 已经主导了自家 26% 的研发工作</strong>。国内这边，云栖大会的芯片是主角。这篇把 9 月底到国庆这几天的动态一次看完。</p>
<section><h2>Gemini 4 Argon：谷歌的「掀桌」时刻（9 月 30 日）<a href="#gemini-4-argon谷歌的掀桌时刻9-月-30-日"><span>#</span></a></h2><p>在 OpenAI 和 Anthropic 相继发布新旗舰之后，谷歌于 9 月 30 日拿出 Gemini 4 系列首款旗舰 <strong>Argon</strong>，官方定位是「迄今最先进的 AI 模型」：</p><ul>
<li><strong>真实世界软件工程任务创下纪录</strong>——不是刷基准，是声称在真实工程场景里跑出了新高度</li>
<li><strong>网络安全能力并列第一</strong>，但初期只向受信任的网安机构和人员开放测试，没有全面放开</li>
<li><strong>多模态专业场景</strong>：能分析专业图表、从长视频中定位内容，面向法律、金融、企业知识工作和长周期复杂任务做了重点优化</li>
<li>安全侧强调<strong>防「越狱」</strong>，发布的同时就把对抗性攻击的防护放在了台面上</li>
</ul><p>社区的反响相当热闹：有评测认为它<strong>追平了 GPT-6 Astra</strong>，也有讨论用「谷歌 80 万行内核已被重写」这样的说法暗示其自我改进能力（这条属于社区渲染，看看就好，以官方口径为准）。但共识是——沉寂了半年多的谷歌，这一手确实把牌桌掀了。</p></section>
<section><h2>OpenAI DevDay 2026：从「卖 Token」到「雇 AI 员工」<a href="#openai-devday-2026从卖-token到雇-ai-员工"><span>#</span></a></h2><p>本届 DevDay 在旧金山举行，一口气推出 <strong>20+ 项更新</strong>，主线只有一个：<strong>ChatGPT 全面转向智能体平台</strong>。</p><section><h3>Dots：常驻型个人智能体<a href="#dots常驻型个人智能体"><span>#</span></a></h3><p>最重磅的产品是 <strong>Dots</strong>——由 GPT-6 Astra 驱动的<strong>常驻（always-on）个人智能体</strong>。它不是「问一句答一句」的聊天机器人，而是能在后台<strong>跨应用持续推进你的目标任务</strong>：规划议程、设计网站、测试应用、修改笔记，官方给它配了四个卡通形象。定位上直接对标 Meta 的同类产品。</p></section><section><h3>Pro 500 与 GPT-6.1 Sol<a href="#pro-500-与-gpt-61-sol"><span>#</span></a></h3><ul>
<li><strong>ChatGPT Pro 500</strong>：每月 <strong>500 美元</strong>的新高端订阅档位——Dots 这类常驻智能体吃 token 的量级，显然不是 $20 档能兜住的</li>
<li><strong>GPT-6.1 Sol</strong>：新模型同步发布</li>
<li><strong>ChatGPT Space</strong>：新的产品形态，面向团队协作场景</li>
</ul><p>整场发布会指向的商业逻辑转变很清晰：<strong>从「按 token 计费卖能力」转向「按月付费雇 AI 员工」</strong>。9 月那篇月报里我说「竞争焦点从问答能力转向智能体工程体验」，这个月 OpenAI 直接把这句话做成了产品。</p></section></section>
<section><h2>Anthropic：一个数字和一次「打脸」<a href="#anthropic一个数字和一次打脸"><span>#</span></a></h2><section><h3>Claude 主导了自家 26% 的研发<a href="#claude-主导了自家-26-的研发"><span>#</span></a></h3><p>Anthropic 公布了一组计划定期更新的新指标，其中最抓眼的：<strong>Claude 已「主导」公司超过四分之一的下一代模型研发工作，占比从零涨到了 26%</strong>。「AI 参与 AI 研发」从口号变成了有量化刻度的常态化指标——这个信号比任何单次跑分都值得留意。</p></section><section><h3>呼吁放慢研发十天后，发了新模型<a href="#呼吁放慢研发十天后发了新模型"><span>#</span></a></h3><p>时间线上还有个耐人寻味的细节：多家领先 AI 公司高管公开表态<strong>支持放慢前沿 AI 研发</strong>的 10 天后（9 月 22 日），Anthropic 和 OpenAI 就都发布了新模型。理想很丰满，竞争节奏不由人。</p></section><section><h3>其他动态<a href="#其他动态"><span>#</span></a></h3><ul>
<li><strong>30+ 开源生物分子模型</strong>：基于 Claude 优化后开源，提升透明度与协作——闭源头部公司主动放出一批专业领域模型，不多见</li>
<li><strong>安全报告</strong>：称已阻止 Claude 被用于网络攻击、舆论操纵和生物武器相关尝试，包括中断一起疑似与俄罗斯有关的网络间谍活动</li>
<li><strong>政府合同延期</strong>：Claude for Government（GSA OneGov）每用户 1 美元的协议延长至 <strong>10 月 31 日</strong></li>
</ul></section></section>
<section><h2>国内：云栖大会，芯片是主角<a href="#国内云栖大会芯片是主角"><span>#</span></a></h2><section><h3>平头哥真武 V900（9 月 22 日）<a href="#平头哥真武-v9009-月-22-日"><span>#</span></a></h3><p>2026 杭州云栖大会上，平头哥正式推出新一代<strong>训推一体 AI 芯片真武 V900</strong>：</p><ul>
<li>单芯片算力达到前代真武 M890 的<strong>三倍</strong></li>
<li>预计 <strong>2027 年量产</strong></li>
<li>前代 M890（今年 5 月发布）内置 144GB 显存、片间互联带宽 800GB/s，配套还有 128 卡超节点服务器</li>
</ul></section><section><h3>真正定调的不是芯片<a href="#真正定调的不是芯片"><span>#</span></a></h3><p>媒体的关注点在 V900，但更有长期意义的是 CEO 吴泳铭在主论坛给出的三年规划：<strong>把 AI 当基建来建</strong>——模型、算力、云三位一体。再叠加「十五五」规划里 <strong>2030 年智算规模 9800 EFLOPS</strong>、算电协同的定调，国内 AI 的叙事正在从「追模型」转向「建底座」。</p></section></section>
<section><h2>暗线：自建模型潮<a href="#暗线自建模型潮"><span>#</span></a></h2><p>还有一条不那么显眼但影响深远的线：<strong>AI 初创公司开始逃离对 OpenAI/Anthropic 的依赖</strong>。模型调用成本持续攀升，越来越多团队转向可自行下载、修改、微调的开放模型。芯片侧的呼应是 <strong>Positron AI</strong> 拿下 8.75 亿美元 C 轮（投后估值 50 亿美元）。当「头部闭源 API」不再等于「唯一选项」，生态的重心才会真正多元化。</p></section>
<section><h2>我的观察<a href="#我的观察"><span>#</span></a></h2><ol>
<li><strong>Agent 从 API 特性变成了产品本体。</strong> 上个月还是「异步工具调用」这种工程特性，这个月已经是 Dots、ChatGPT Space 这种直接面向用户的产品形态。迁移速度比大多数人预想的快。</li>
<li><strong>「AI 参与 AI 研发」开始有刻度。</strong> 26% 这个数字的意义不在大小，而在于头部实验室愿意把它当常规指标定期公布——递归自我改进从论文用语变成了运营数据。</li>
<li><strong>底座之争并行于模型之争。</strong> 真武 V900、智算规划、自建模型潮、开源生物分子模型，指向同一件事：模型层的热闹之下，算力与开放生态的结构性竞争已经开场。</li>
</ol></section>
<section><h2>资料来源<a href="#资料来源"><span>#</span></a></h2><ul>
<li><a href="https://finance.sina.com.cn" target="_blank">新浪财经：谷歌推出最先进的 AI 模型 Gemini 4 Argon</a></li>
<li><a href="https://view.inews.qq.com" target="_blank">腾讯新闻：Gemini 4 震撼发布</a></li>
<li><a href="https://companies.caixin.com" target="_blank">财新：谷歌发布 Gemini 4 模型，强调安全防「越狱」</a></li>
<li><a href="https://bytechap.com" target="_blank">bytechap：OpenAI launches Dots agents and a $500 monthly Pro tier at DevDay 2026</a></li>
<li><a href="https://news.qq.com" target="_blank">通信产业：OpenAI DevDay 2026，Agent 加速与安全裂痕并行</a></li>
<li><a href="https://news.ifeng.com" target="_blank">凤凰网：从零到 26%，Claude 已主导公司下一代模型的部分研发</a></li>
<li><a href="https://malaysia.news.yahoo.com" target="_blank">Yahoo News：Anthropic says it stopped AI misuse for cyberattacks, propaganda and bioweapons</a></li>
<li><a href="https://www.sohu.com" target="_blank">搜狐：阿里平头哥真武 V900 亮相，2027 年量产</a></li>
<li><a href="https://www.163.com" target="_blank">网易：云栖大会的更大看点，阿里把 AI 当基建</a></li>
<li><a href="https://news.cnyes.com" target="_blank">钜亨网：AI 初创掀自建模型潮</a></li>
</ul></section>]]></content>
    </entry>
    <entry>
      <id>https://liqiming.top/posts/ai-news-2026-09/</id>
      <title type="text">2026 年 9 月 AI 圈：GPT-6 Astra 对线 Fable 5.1，国产模型贴身肉搏</title>
      <published>2026-09-19T00:00:00.000Z</published>
      <updated>2026-09-19T00:00:00.000Z</updated>
      <author><name>图明</name></author>
      <link rel="alternate" href="https://liqiming.top/posts/ai-news-2026-09/"/>
      <summary type="text">月初三天的「超级发布周」把旗舰之争推到白热化；DeepSeek 降价、智谱 GLM-5.3 冲榜，这个月值得关注的动态一次看完。</summary>
      <content type="html"><![CDATA[<p>9 月的 AI 圈可以用一个词形容：<strong>贴身肉搏</strong>。海外四家在三天内密集放出新模型，国产阵营用降价和新品接招。这篇文章把我这个月跟踪到的关键动态整理成一篇，方便你快速补课。</p>
<section><h2>超级发布周：三天四家<a href="#超级发布周三天四家"><span>#</span></a></h2><p>9 月初出现了罕见的「超级发布周」：Anthropic、Google、Meta、OpenAI 在<strong>三天内</strong>先后发布新模型，单月统计有 22 项 AI 相关发布。密度高到评测机构都来不及跑分。</p><section><h3>GPT-6 Astra（OpenAI，9 月 3 日）<a href="#gpt-6-astraopenai9-月-3-日"><span>#</span></a></h3><p>OpenAI 的这代旗舰初期只向部分机构开放，几天后开放到全量订阅用户。除了能力本身的提升，我更关注它在 <strong>Responses API</strong> 上的三个工程化改进：</p><ul>
<li><strong>异步工具调用</strong>——发起工具调用后不必阻塞等待结果，长时智能体的并行度上了一个台阶</li>
<li><strong>回合中途引导</strong>——允许在模型执行到一半时插入新的指令纠偏，这对 Agent 工作流是刚需</li>
<li><strong>保留缓存前缀的推理强度调整</strong>——调高/调低推理力度时不用丢弃已有的上下文缓存，省钱</li>
</ul><p>这几个特性都指向同一个方向：<strong>模型竞争的焦点正在从”单次问答能力”转向”智能体工作负载的工程体验”</strong>。</p></section><section><h3>Claude Fable 5.1（Anthropic）<a href="#claude-fable-51anthropic"><span>#</span></a></h3><p>与 GPT-6 同期发布的 Fable 5.1 没有在能力上被拉开，反而在成本侧给出了很实际的改进：<strong>降低缓存读取费用</strong>，强化长上下文与重度 Agent 工作负载的成本优势。</p><p>第三方综合评测里，Fable 5.1 与 GPT-6 Astra 位列前两名（AA v4.2 评分 57 vs 55），上一代旗舰 Opus 5 以 54 分居第三。有趣的是社区舆论的分裂：一部分讨论认为 Fable 5.1 依然是第一梯队的稳妥选择，另一部分媒体则渲染”GPT-6 碾压”。<strong>旗舰之争已经从比能力延伸到比定价</strong>，这对开发者是好事。</p></section><section><h3>Meta Muse Spark 1.3<a href="#meta-muse-spark-13"><span>#</span></a></h3><p>Meta 这个月发布的 Muse Spark 1.3 在编程和智能体能力上有明显跃升，综合性能逼近 OpenAI 与 Anthropic 的最新旗舰。开源阵营能有这个身位，竞争格局确实在变。</p></section></section>
<section><h2>国产阵营：降价与冲榜<a href="#国产阵营降价与冲榜"><span>#</span></a></h2><section><h3>DeepSeek：一边提价一边降价<a href="#deepseek一边提价一边降价"><span>#</span></a></h3><p>DeepSeek 的动态看起来矛盾但其实很清晰：</p><ul>
<li><strong>8 月 17 日</strong>部分 API 提价生效（据分析是主动调整产品结构）</li>
<li><strong>9 月 10 日</strong> V4.1 Flash 大幅<strong>降价</strong>：缓存命中输入降 60%，未命中输入降约 33%，输出降约 11%</li>
</ul><p>逻辑不难理解：旗舰维持合理利润，轻量模型用低价抢调用量。效果也直接——DeepSeek 的调用量已<strong>连续二十周领跑</strong>国内大模型榜单，全球调用量前五里有四款是中国模型。</p></section><section><h3>智谱：GLM-5.3 主打编程<a href="#智谱glm-53-主打编程"><span>#</span></a></h3><p>8 月 19 日上线的 GLM-5.3 在内部 Code Bench 上较 GLM-5.2 <strong>提升 50%</strong> 的编程能力，成为 9 月榜单前十中位次最高的国产开源模型。再往前，6 月的 GLM-5.2 曾在 Artificial Analysis 智能指数排到全球第三。</p></section></section>
<section><h2>我的观察<a href="#我的观察"><span>#</span></a></h2><p>把这几件事放在一起看，有三条趋势值得记住：</p><ol>
<li><strong>Agent 是所有发布的主线。</strong> 异步工具调用、中途引导、缓存友好的推理调整——新特性几乎全是为长时间运行的智能体设计的，而不是为了聊天。</li>
<li><strong>价格战开打了。</strong> 缓存降价、Flash 档位降价，说明 token 成本曲线还在快速下探，重度 Agent 应用的基础设施账算得过来了。</li>
<li><strong>开源与闭源的差距在收窄。</strong> Meta 与国产开源模型冲进前十，“必须用闭源旗舰”的假设越来越不成立。</li>
</ol></section>
<section><h2>资料来源<a href="#资料来源"><span>#</span></a></h2><ul>
<li><a href="https://evolink.ai" target="_blank">Claude Fable 5.1 vs GPT-6 Astra：编程、Agent 与成本</a></li>
<li><a href="https://zhuanlan.zhihu.com" target="_blank">30 款主流 AI 大模型排行榜（2026 年 9 月）</a></li>
<li><a href="https://www.datalearner.com" target="_blank">AI 大模型评测排行榜（Datalearner）</a></li>
<li><a href="https://news.cnyes.com" target="_blank">Meta 发布 Muse Spark 1.3（钜亨网）</a></li>
<li><a href="https://docs.bigmodel.cn" target="_blank">智谱 GLM-5.3 官方文档</a></li>
<li><a href="https://k.sina.com.cn" target="_blank">新浪 AI 投资峰会报道</a></li>
</ul></section>]]></content>
    </entry>
    <entry>
      <id>https://liqiming.top/posts/redis-intrusion-postmortem/</id>
      <title type="text">一次真实的 Redis 入侵：我的服务器是怎么被打进来的，以及我是怎么修的</title>
      <published>2026-09-19T00:00:00.000Z</published>
      <updated>2026-09-19T00:00:00.000Z</updated>
      <author><name>图明</name></author>
      <link rel="alternate" href="https://liqiming.top/posts/redis-intrusion-postmortem/"/>
      <summary type="text">弱密码 + 公网端口，两天内被两个 IP 光顾：一个清了我的库，一个把数据同步到了他的服务器。完整复盘发现、取证、修复全过程。</summary>
      <content type="html"><![CDATA[<p>上周我的服务器被入侵了。不是演习，不是靶机，是我自己那台跑着博客和 AI 应用平台的腾讯云轻量服务器。这篇文章是完整的复盘：攻击者怎么进来的、做了什么、我怎么发现的、怎么取证和修复的。<strong>每一步都有真实证据，不是安全教育文里的”假设场景”。</strong></p>
<section><h2>症状：网站中间空白，刷新也没用<a href="#症状网站中间空白刷新也没用"><span>#</span></a></h2><p>最先发现的是用户反馈：AI 应用平台打开后<strong>只有头尾、中间一片空白</strong>，刷新也不行。</p><p>“刷新不好使”这个细节很关键——它排除了最常见的”静态资源缓存问题”（那种刷新就好了）。我用无头浏览器渲染页面并对照 nginx 访问日志，发现真正的异常是：</p><div><figure><figcaption></figcaption><pre><code><div><div><div>1</div></div><div><span>GET /api/user/get/login  →  500</span></div></div></code></pre><div><div></div><div></div></div></figure></div><p>前端是”先查登录状态、再渲染主界面”的模式，接口 500，页面就停在空白。</p></section>
<section><h2>顺着 500 往下挖<a href="#顺着-500-往下挖"><span>#</span></a></h2><p>应用日志里的报错很反常：</p><div><figure><figcaption></figcaption><pre><code><div><div><div>1</div></div><div><span>READONLY You can't write against a read only replica.</span></div></div></code></pre><div><div></div><div></div></div></figure></div><p>一台<strong>独立部署</strong>的 Redis，怎么会是”只读副本”？查复制状态：</p><div><figure><figcaption></figcaption><pre><code><div><div><div>1</div></div><div><span>role:slave</span></div></div><div><div><div>2</div></div><div><span>master_host:175.24.232.83</span></div></div><div><div><div>3</div></div><div><span>master_link_status:down</span></div></div></code></pre><div><div></div><div></div></div></figure></div><p>我的 Redis 被人配置成了<strong>另一个 IP 的从库</strong>——而且那个主库根本连不上。应用往 Redis 写 session 被拒绝，于是接口 500。</p></section>
<section><h2>SLOWLOG：攻击者留下了完整作案记录<a href="#slowlog攻击者留下了完整作案记录"><span>#</span></a></h2><p>Redis 的慢日志记下了精确到秒的时间线，<strong>两个攻击者，两次入侵</strong>：</p>

<table><thead><tr><th>时间</th><th>来源</th><th>命令</th></tr></thead><tbody><tr><td>9 月 16 日 21&lt;12&gt;</td><td><code>144.225.8.52</code></td><td><code>FLUSHDB</code>（清空全库）、<code>info</code></td></tr><tr><td>9 月 18 日 23&lt;05&gt;</td><td><code>175.24.232.83</code></td><td><code>slaveof 175.24.232.83 23485</code> + <code>config set stop-writes-on-bgsave-error no</code></td></tr></tbody></table><p>第二次那两条命令组合是标准的<strong>数据外带</strong>手法：把被控 Redis 设成攻击者的从库，主库会把全量数据同步过去，等于打包偷走。配套的 <code>stop-writes-on-bgsave-error no</code> 是为了保证 RDB 快照能顺利生成。</p><p>回头看，9 月 16 日的 <code>FLUSHDB</code> 其实已经是响亮的警报——那天所有用户都被登出过，只是没人把它和”入侵”联系起来。</p></section>
<section><h2>入口：一个 2016 年就有的老洞<a href="#入口一个-2016-年就有的老洞"><span>#</span></a></h2><p>弱密码 <code>root</code>，加上 6379 对公网开放。十年前的入侵套路，2026 年照样打得穿。</p><p>这里有个<strong>很多人栽过的坑</strong>：我服务器上 ufw 明明是”默认拒绝”、放行列表里根本没有 6379，为什么外网还是连得上？——<strong>Docker 会绕过 ufw</strong>。容器把端口发布到 <code>0.0.0.0</code> 时，Docker 直接往 iptables 里插规则，优先级高于 ufw。所以 ufw 界面看着滴水不漏，实际上数据库端口全网裸奔。</p></section>
<section><h2>取证：先确认失陷范围，再动手修<a href="#取证先确认失陷范围再动手修"><span>#</span></a></h2><p>确认入侵后我没有急着删删改改，而是先做取证——<strong>清了就没了</strong>。逐项排查：</p><ul>
<li><code>MODULE LIST</code> → 空（无后门模块）</li>
<li><code>CONFIG GET dir / dbfilename</code> → 正常值（没被改成写 SSH key / 计划任务的目标路径）</li>
<li>挖矿进程、UID=0 异常用户、对外连接（C2/矿池）→ 全部干净</li>
<li>SSH 七天内无密码登录成功记录，<code>authorized_keys</code> 只有合法密钥</li>
<li>计划任务只有腾讯官方组件和证书续期</li>
<li>Redis 容器<strong>非特权模式</strong>、独立网络栈 → 没有逃逸到宿主机</li>
</ul><p>结论：<strong>失陷范围仅限 Redis</strong>。泄露的内容是约 45 个键，几乎全部是 <code>spring:session:*</code>——<strong>全部用户的会话令牌</strong>，攻击者可以冒充任何已登录用户。而 jar 包里的模型 API Key、对象存储密钥没有经由这条路径泄露。</p></section>
<section><h2>修复：顺序很重要<a href="#修复顺序很重要"><span>#</span></a></h2><p>我的处置顺序是<strong>止血 → 取证 → 轮换凭据 → 收口网络 → 作废赃物 → 加固入口</strong>：</p><ol>
<li><strong>止血</strong>：<code>REPLICAOF NO ONE</code> 断开外带通道。一条命令同时止住数据外带和业务中断</li>
<li><strong>凭据轮换</strong>：Redis 密码换成 48 位随机值，旧密码实测被拒</li>
<li><strong>收口网络</strong>：把 Redis 和 MySQL 的 Docker 端口映射从 <code>0.0.0.0</code> 改绑 <code>127.0.0.1</code>（釜底抽薪，不跟 ufw 缠斗），外网实测两个端口关闭</li>
<li><strong>改应用配置</strong>：数据库连接从公网 IP 改为 <code>127.0.0.1</code>——顺便说一句，配置里那个公网 IP 是”服务器连自己”，流量本来就不出机器，改成本地地址是等价且更清晰的</li>
<li><strong>作废赃物</strong>：<code>FLUSHDB</code> 清空全部会话。这步最容易被漏掉——<strong>不作物废，攻击者偷走的令牌在修复后依然有效</strong></li>
<li><strong>加固入口</strong>：SSH 关闭密码登录（只留密钥）、管理面板换随机安全入口 + 开防爆破</li>
</ol><p>修复后全量回归：网站、评论区、AI 平台全部恢复正常。</p></section>
<section><h2>复盘：三个教训<a href="#复盘三个教训"><span>#</span></a></h2><p><strong>1. “看着关了”不等于”关了”。</strong> ufw 显示没放行、外网却能连——Docker 绕过 ufw 是部署期就该知道的坑。端口安全要<strong>从外网实测</strong>，不能只看防火墙界面。</p><p><strong>2. 告警的缺失让事件拖了两天。</strong> 9 月 16 日的 <code>FLUSHDB</code> 让所有用户掉线，那本该是发现入侵的时刻，实际却拖到 18 日业务挂掉。键数一夜清零、<code>role</code> 从 master 变 slave、日志出现 READONLY——任何一条接上告警，事件当天就能被处理。</p><p><strong>3. 处置顺序决定二次伤害。</strong> 先取证再清理（证据不能再生）；先改密码再关端口（单改一样都会留下窗口）；修复完必须作废被窃的凭证（尤其是会话令牌这种”看不见的赃物”）。</p></section>
<section><h2>给你的清单<a href="#给你的清单"><span>#</span></a></h2><p>如果你也有公网服务器，花两分钟自查：</p><div><figure><figcaption><span></span><span>Terminal window</span></figcaption><pre><code><div><div><div>1</div></div><div><span># 端口从外网实测（不是看防火墙界面）</span></div></div><div><div><div>2</div></div><div><span>nc</span><span> </span><span>-z</span><span> </span><span>-w</span><span> </span><span>5</span><span> </span><span>你的服务器IP</span><span> </span><span>6379</span></div></div><div><div><div>3</div></div><div>
</div></div><div><div><div>4</div></div><div><span># Redis 弱密码 + 复制状态</span></div></div><div><div><div>5</div></div><div><span>redis-cli</span><span> </span><span>-a</span><span> </span><span>你的密码</span><span> </span><span>INFO</span><span> </span><span>replication</span><span> | </span><span>grep</span><span> </span><span>-E</span><span> </span><span>"^role|master"</span></div></div><div><div><div>6</div></div><div>
</div></div><div><div><div>7</div></div><div><span># 有没有奇怪的慢日志</span></div></div><div><div><div>8</div></div><div><span>redis-cli</span><span> </span><span>-a</span><span> </span><span>你的密码</span><span> </span><span>SLOWLOG</span><span> </span><span>GET</span><span> </span><span>10</span></div></div></code></pre><div><div></div><div></div></div></figure></div><p>数据库端口绑 <code>127.0.0.1</code>、强密码、关 SSH 密码登录——这三件事做完，这类攻击的入口就基本堵死了。</p><hr /><p><em>本文细节已做脱敏处理（隐去服务器地址与管理入口）。攻击者 IP 保留原文，作为事件证据。</em></p></section>]]></content>
    </entry>
    <entry>
      <id>https://liqiming.top/posts/agents-api/</id>
      <title type="text">Agents API：把长时智能体变成可运营的工程系统</title>
      <published>2026-09-10T00:00:00.000Z</published>
      <updated>2026-09-10T00:00:00.000Z</updated>
      <author><name>图明</name></author>
      <link rel="alternate" href="https://liqiming.top/posts/agents-api/"/>
      <summary type="text">OpenAI 发布 Agents API 公测版后，智能体的重点从单次对话转向会话、工具、恢复和长期运行。</summary>
      <content type="html"><![CDATA[<p>OpenAI 在 2026 年 9 月发布了 <strong>Agents API</strong> 公测版。它把长时间运行的智能体所需要的会话管理、工具编排、子智能体协作、文件和代码执行环境，整理成了一个托管 API。</p>
<section><h2>变化在哪里<a href="#变化在哪里"><span>#</span></a></h2><p>传统的 LLM 调用通常是“请求一次、返回一次”。智能体要连续工作，就必须额外处理上下文压缩、任务恢复、工具失败、环境持久化和权限边界。Agents API 把这些问题放进运行时，开发者可以把更多精力放在业务工具和评估上。</p><p>一个可维护的智能体通常至少需要四层：</p><ol>
<li><strong>任务层</strong>：把用户目标拆成可检查的步骤。</li>
<li><strong>上下文层</strong>：保存对话、文件和中间结果，并在接近上限时压缩。</li>
<li><strong>工具层</strong>：以明确的输入输出契约连接搜索、代码、数据库或内部系统。</li>
<li><strong>恢复层</strong>：记录每一步状态，失败后能够重试、回滚或交给人工处理。</li>
</ol></section>
<section><h2>对个人项目的启发<a href="#对个人项目的启发"><span>#</span></a></h2><p>如果只是做问答，直接调用模型 API 就够了。如果要做自动整理资料、生成周报或维护代码，建议先把工具调用设计成幂等操作，再为每个工具记录耗时、错误和副作用。这样即使智能体重试，也不会重复发送邮件、写入订单或覆盖文件。</p><p>我会把这类系统的最小闭环定为：<strong>目标 → 计划 → 工具调用 → 结果校验 → 可恢复状态</strong>。模型负责推理，业务代码负责边界和事实，二者不要混在一段提示词里。</p><div><div><div></div><div>Tip</div></div><div><p>长时智能体的核心指标不是“回答看起来聪明”，而是任务完成率、失败可恢复率、工具调用正确率和人工接管成本。</p></div></div><p>原始来源：<a href="https://openai.com/index/introducing-the-agents-api/" target="_blank">Introducing the Agents API</a>。</p></section>]]></content>
    </entry>
    <entry>
      <id>https://liqiming.top/posts/ai-safety-misuse/</id>
      <title type="text">从真实滥用案例看 AI 系统的安全边界</title>
      <published>2026-09-10T00:00:00.000Z</published>
      <updated>2026-09-10T00:00:00.000Z</updated>
      <author><name>图明</name></author>
      <link rel="alternate" href="https://liqiming.top/posts/ai-safety-misuse/"/>
      <summary type="text">Anthropic 发布 2026 年 9 月威胁情报报告，展示模型被用于网络、影响、监控和数据蒸馏等活动时的防御重点。</summary>
      <content type="html"><![CDATA[<p>Anthropic 在 2026 年 9 月发布了新的威胁情报报告，回顾 2025 年 12 月至 2026 年 8 月期间识别和中断的多类 Claude 滥用活动，范围包括网络攻击、影响行动、监控、诈骗、生物风险和未经授权的能力蒸馏。</p>
<section><h2>安全问题已经从“回答什么”变成“能完成什么”<a href="#安全问题已经从回答什么变成能完成什么"><span>#</span></a></h2><p>当模型可以调用工具、编写代码、访问浏览器和连续运行时，风险不再只来自一条危险回答。攻击者可能把多个普通能力串成完整流程：收集数据、建立账号、生成内容、运行脚本，再通过自动化扩大规模。</p><p>因此，安全控制不能只放在提示词里，至少还需要：</p><ul>
<li><strong>身份与权限</strong>：为高风险工具绑定最小权限和短时令牌。</li>
<li><strong>行为监测</strong>：观察工具调用序列、访问频率和异常资源使用，而不是只检查文本。</li>
<li><strong>可撤销性</strong>：让账号封禁、任务停止和密钥轮换可以快速执行。</li>
<li><strong>跨组织协作</strong>：在不泄露用户隐私的前提下，共享指标和攻击特征。</li>
</ul><p>报告还提醒开发者，未经授权的模型蒸馏会把敏感数据和高能力输出一起带出系统。生产环境应该明确数据保留、日志访问和第三方路由边界，尤其不要把 API 密钥、内部文档或个人数据直接交给不受控的代理链路。</p><p>安全不是发布前的一次审核，而是贯穿模型、工具、账号和基础设施的持续反馈回路。</p><p>原始来源：<a href="https://www.anthropic.com/threat-intelligence-report-september-2026" target="_blank">Detecting and countering misuse of AI: September 2026</a>。</p></section>]]></content>
    </entry>
    <entry>
      <id>https://liqiming.top/posts/gpt-live-api/</id>
      <title type="text">GPT-Live-1：全双工语音 API 带来的工程变化</title>
      <published>2026-09-10T00:00:00.000Z</published>
      <updated>2026-09-10T00:00:00.000Z</updated>
      <author><name>图明</name></author>
      <link rel="alternate" href="https://liqiming.top/posts/gpt-live-api/"/>
      <summary type="text">从轮流收听到同时听说，全双工语音模型让语音智能体减少中间层与等待时间。</summary>
      <content type="html"><![CDATA[<p>GPT-Live-1 在 2026 年 9 月进入 API，主打自然的全双工语音交互。模型可以在听用户说话的同时生成回应，支持打断、背景噪声和较长会话，也可以把更复杂的推理或工具调用交给后端文本模型。</p>
<section><h2>为什么全双工重要<a href="#为什么全双工重要"><span>#</span></a></h2><p>传统语音应用常见的链路是 <strong>语音识别 → 文本模型 → 语音合成</strong>。这条链路容易出现三个问题：模块之间要反复传递状态，用户打断时需要取消多个请求，系统还要自己判断什么时候算一句话结束。</p><p>全双工模型把输入和输出音频放在同一个交互循环中，打断处理变成模型能力的一部分。OpenAI 在发布说明中提到，早期评估里 Speak 的语言学习场景将打断次数降低了接近 80%；这类结果仍然需要结合自己的场景和指标复测。</p></section>
<section><h2>接入时要注意什么<a href="#接入时要注意什么"><span>#</span></a></h2><ul>
<li><strong>把工具调用放到后端</strong>：语音模型负责对话节奏，订单、检索和写入等动作仍由服务端鉴权。</li>
<li><strong>设置明确的打断策略</strong>：用户重新说话时，前端要立即停止播放，并保留未完成请求的取消信号。</li>
<li><strong>记录音频延迟</strong>：拆分首包延迟、端到端响应延迟和用户打断恢复时间，不能只看模型生成速度。</li>
<li><strong>给长会话做摘要</strong>：实时音频上下文会快速增长，应该按主题或任务生成短摘要，避免无限累积。</li>
</ul><p>对于客服、语言练习和语音导航，降低等待感比增加一堆按钮更重要。全双工的价值最终要用“用户是否愿意继续说下去”来验证。</p><p>原始来源：<a href="https://openai.com/index/introducing-gpt-live-1-in-the-api/" target="_blank">Build more natural voice experiences with GPT-Live-1 in the API</a>。</p></section>]]></content>
    </entry>
    <entry>
      <id>https://liqiming.top/posts/ai-policy-window/</id>
      <title type="text">前沿模型能力加速后，安全护栏如何跟上</title>
      <published>2026-09-09T00:00:00.000Z</published>
      <updated>2026-09-09T00:00:00.000Z</updated>
      <author><name>图明</name></author>
      <link rel="alternate" href="https://liqiming.top/posts/ai-policy-window/"/>
      <summary type="text">从前沿模型的能力增长、评估和监控出发，梳理 AI 产品进入生产环境前需要补齐的安全机制。</summary>
      <content type="html"><![CDATA[<p>当模型能力快速增长时，安全评估不能只在模型发布前做一次。OpenAI 近期公开的政策文章提到，前沿系统需要更强的监控、对齐评估和安全门槛，尤其要关注工具调用、完整轨迹和模型行为的变化。</p>
<section><h2>工程上应该留下什么证据<a href="#工程上应该留下什么证据"><span>#</span></a></h2><p>一个可以被审计的 AI 功能，至少应该记录：</p><ol>
<li>使用的模型版本、系统提示和工具清单。</li>
<li>每一次外部操作的参数、权限和返回结果。</li>
<li>被拒绝、被人工接管和失败重试的原因。</li>
<li>评估集版本、回归结果和已知限制。</li>
</ol><p>这些信息让团队知道“系统为什么做了这件事”，也让问题出现后能够复盘，而不是只剩下一段聊天记录。</p></section>
<section><h2>把安全门槛做成发布流程<a href="#把安全门槛做成发布流程"><span>#</span></a></h2><p>在模型或工具升级时，可以把关键安全评估接入 CI：先运行越权、敏感数据泄露和工具滥用测试，再比较能力指标是否出现异常跳升。对于会发送消息、修改文件或操作账户的智能体，还应增加人工确认或可撤销窗口。</p><p>安全机制的目标不是让系统什么都不做，而是在系统能力变强时，让风险边界、监测信号和停止按钮同步变清楚。</p><p>原始来源：<a href="https://openai.com/index/ai-policy-window/" target="_blank">The AI policy window is open. We need to act.</a>。</p></section>]]></content>
    </entry>
    <entry>
      <id>https://liqiming.top/posts/research-acceleration/</id>
      <title type="text">当编码智能体进入研究工作流：从写代码到跑实验</title>
      <published>2026-09-06T00:00:00.000Z</published>
      <updated>2026-09-06T00:00:00.000Z</updated>
      <author><name>图明</name></author>
      <link rel="alternate" href="https://liqiming.top/posts/research-acceleration/"/>
      <summary type="text">OpenAI 分享研究团队如何使用编码智能体，观察自动化对实验、基础设施和技术支持的影响。</summary>
      <content type="html"><![CDATA[<p>OpenAI 在 2026 年 9 月公开了研究团队使用编码智能体的内部观察。文章把 AI 研究拆成代码、评估、基础设施、监控和训练集成等环节，讨论智能体究竟改变了哪些瓶颈。</p>
<section><h2>一个值得关注的信号<a href="#一个值得关注的信号"><span>#</span></a></h2><p>截至 2026 年 8 月，文章称研究组织每天使用的智能体工作量约为人类工作日的 3.1 倍。这个数字不是“模型替代了多少人”，而是说明研究人员开始同时运行多个智能体，把它们当作可并行的实验助手。</p><p>更容易自动化的是写胶水代码、排查实验基础设施、生成评估脚本和整理运行结果。更难自动化的是提出真正有价值的研究问题、判断实验是否公平、识别数据泄漏，以及决定一个结果是否值得投入更大算力。</p></section>
<section><h2>对工程团队的三个建议<a href="#对工程团队的三个建议"><span>#</span></a></h2><ol>
<li><strong>先做可重复的实验入口</strong>：把环境、数据版本、参数和评估命令写进脚本，智能体才有可靠的执行边界。</li>
<li><strong>把评估当作产品</strong>：每次修改都自动记录基线、失败案例和回归结果，避免只看一个漂亮的平均分。</li>
<li><strong>把人放在决策节点</strong>：模型可以提出假设、写代码和跑实验，但研究结论、发布和高风险操作需要人工复核。</li>
</ol><p>智能体的价值不只是节省几分钟打字时间，更在于把原本串行的试错过程变成可以并行探索的工作流。前提是，团队必须先把实验过程变得可观测、可回滚、可比较。</p><p>原始来源：<a href="https://openai.com/index/research-acceleration-view-inside-openai/" target="_blank">Research acceleration: The view inside OpenAI</a>。</p></section>]]></content>
    </entry>
    <entry>
      <id>https://liqiming.top/posts/webgpu-kernels/</id>
      <title type="text">在浏览器里跑更快的本地 AI：Hugging Face WebGPU Kernels</title>
      <published>2026-09-01T00:00:00.000Z</published>
      <updated>2026-09-01T00:00:00.000Z</updated>
      <author><name>图明</name></author>
      <link rel="alternate" href="https://liqiming.top/posts/webgpu-kernels/"/>
      <summary type="text">Hugging Face 发布 @huggingface/kernels，用可版本化的 WGSL 内核改善浏览器端推理性能。</summary>
      <content type="html"><![CDATA[<p>浏览器端 AI 的上限不只由模型格式决定，还取决于矩阵乘法、归一化、注意力和量化等底层 GPU 操作。Hugging Face 在 2026 年 9 月发布了 <code>@huggingface/kernels</code>，把这些操作包装成可发现、可测试、可基准测试的 WebGPU 内核。</p>
<section><h2>这个项目解决什么问题<a href="#这个项目解决什么问题"><span>#</span></a></h2><p>新库首批发布了 207 个 Apache-2.0 许可的 WebGPU 内核。每个内核都带有接口契约、正确性用例、基准用例和 WGSL 着色器模板，应用可以按版本加载，而不必依赖一条无法复现的远程脚本。</p><p>这种组织方式很适合浏览器推理：上层运行时负责图和张量，下层内核负责在不同 GPU 和浏览器上选择更合适的实现。Hugging Face 还发布了 Fleet，用来收集真实设备上的正确性与性能证据。</p></section>
<section><h2>如何理解性能数据<a href="#如何理解性能数据"><span>#</span></a></h2><p>发布文章在 Apple M4 上将 809 个可比用例与 ONNX Runtime Web 进行比较，给出的几何平均加速约为 2.57 倍，中位数约为 1.90 倍。这是单个操作的 GPU 执行时间，不是完整模型端到端速度；模型加载、编译、数据上传和结果回读仍然会影响最终体验。</p><p>如果你要在前端尝试本地 AI，可以按这个顺序排查：</p><ul>
<li>先确认浏览器存在 <code>navigator.gpu</code>。</li>
<li>用真实设备测量，而不是只看桌面开发机。</li>
<li>分开统计 shader 编译、首 token、稳态吞吐和显存占用。</li>
<li>给每种输入形状保留基准，避免只优化一个 demo。</li>
</ul><p>WebGPU 的价值在于把推理带回用户设备，但可复现的内核契约和设备侧基准，才是让它从演示走向产品的基础。</p><p>原始来源：<a href="https://huggingface.co/blog/webgpu-kernels" target="_blank">Introducing @huggingface/kernels: 200+ WebGPU Kernels for Local AI</a>。</p></section>]]></content>
    </entry>
</feed>