


从 SSG 到全栈:我给博客造了一个管理后台
我的博客 liqiming.top 跑在 Astro 7 SSG 上,前台渲染速度和 SEO 都无可挑剔,但静态站点有一个天然的问题:发一篇文章要开编辑器写 Markdown、起终端跑构建、传服务器——写作的心流全被打断。所以我干脆把整条链路重做了一遍:给博客配了一个生产级管理后台,内容写作、评论管理、访客统计、构建发布全部在线闭环。
这篇文章把整套方案讲清楚:架构怎么设计、每一步用了什么技术、为什么这么选、踩了哪些坑。整套东西从服务端到前端全部自建,没有引入任何 SaaS。初版上线三周后功能长了一圈——评论管理、热门文章、邮件通知开关都是后来补的——这篇是修订版,把现状一次写全。
一、整体架构
浏览器 ├─ 前台博客(Astro SSG 静态站,OpenResty 直接服务) ├─ 评论区(自托管 Artalk,OpenResty 反代) └─ 管理后台 SPA(Vue3 + Naive UI,/admin/) ↓ /api/* OpenResty(静态优先,动态反代) ↓ Admin Server(Hono + node:sqlite,127.0.0.1:4322) ├─ 协议适配层:内容 CRUD → 直接读写 Markdown 文件树 ├─ Artalk 适配层:评论管理 → 直读 artalk.db + 调 Artalk API ├─ 自建统计:埋点接收 → IP 地域解析 → 指纹去重 └─ 发布管线:触发构建 → 原子交换上线核心决策有三个:
静态归静态,动态归动态。 前台依然是纯 SSG 产物,构建出来就是一堆 HTML,性能不妥协;管理后台是独立 SPA + 独立 API 服务,通过反向代理挂在同一域名下的 /admin/ 和 /api/。OpenResty 按”静态文件优先、打不到再反代”的顺序分流,博客自己的 /api/dynamic.json 和管理台的 /api/v1/report 互不干扰。
内容的事实源仍是 Markdown 文件。 后台没有把文章搬进数据库,而是直接读写仓库里的 Markdown 文件树——frontmatter 解析用 gray-matter,写回时只做最小字段 patch,保住原有键序和格式。这带来一个很爽的性质:后台挂了,博客照常跑;任何时候抛弃后台,仓库还是那个仓库。
SQLite 单文件数据库承载一切状态。 会话、审计日志、访客统计全在一个 admin.db 里,备份就是拷文件。评论数据在 Artalk 自己的 artalk.db 里,评论管理直接读它——这点后面细说。
有一段插曲值得记:规划文档(9 条 ADR)里管理台前端原本定的是 Svelte 5 自研。做到一半我发现了开源项目 aurora 的管理后台,布局和交互都比我当时的设计成熟,于是改变策略——前端 100% 照搬 aurora(Vue3 + Naive UI),服务端写了一层约 1200 行的协议适配层,让 aurora 的接口契约直接落到我自己的 Markdown 文件树和 SQLite 上。ADR 没跟上实现,这属于”发现更好的轮子就换”:自研 UI 的时间省下来砸在了适配层和数据真实性上。复盘看这笔账是划算的——代价是我继承了 aurora 的一些遗留代码(后文踩坑实录里有两个坑就是它的)。
二、管理后台全景:每个页面都在干什么
管理台现在有 20 多个页面,按实装程度分三类,如实交代:
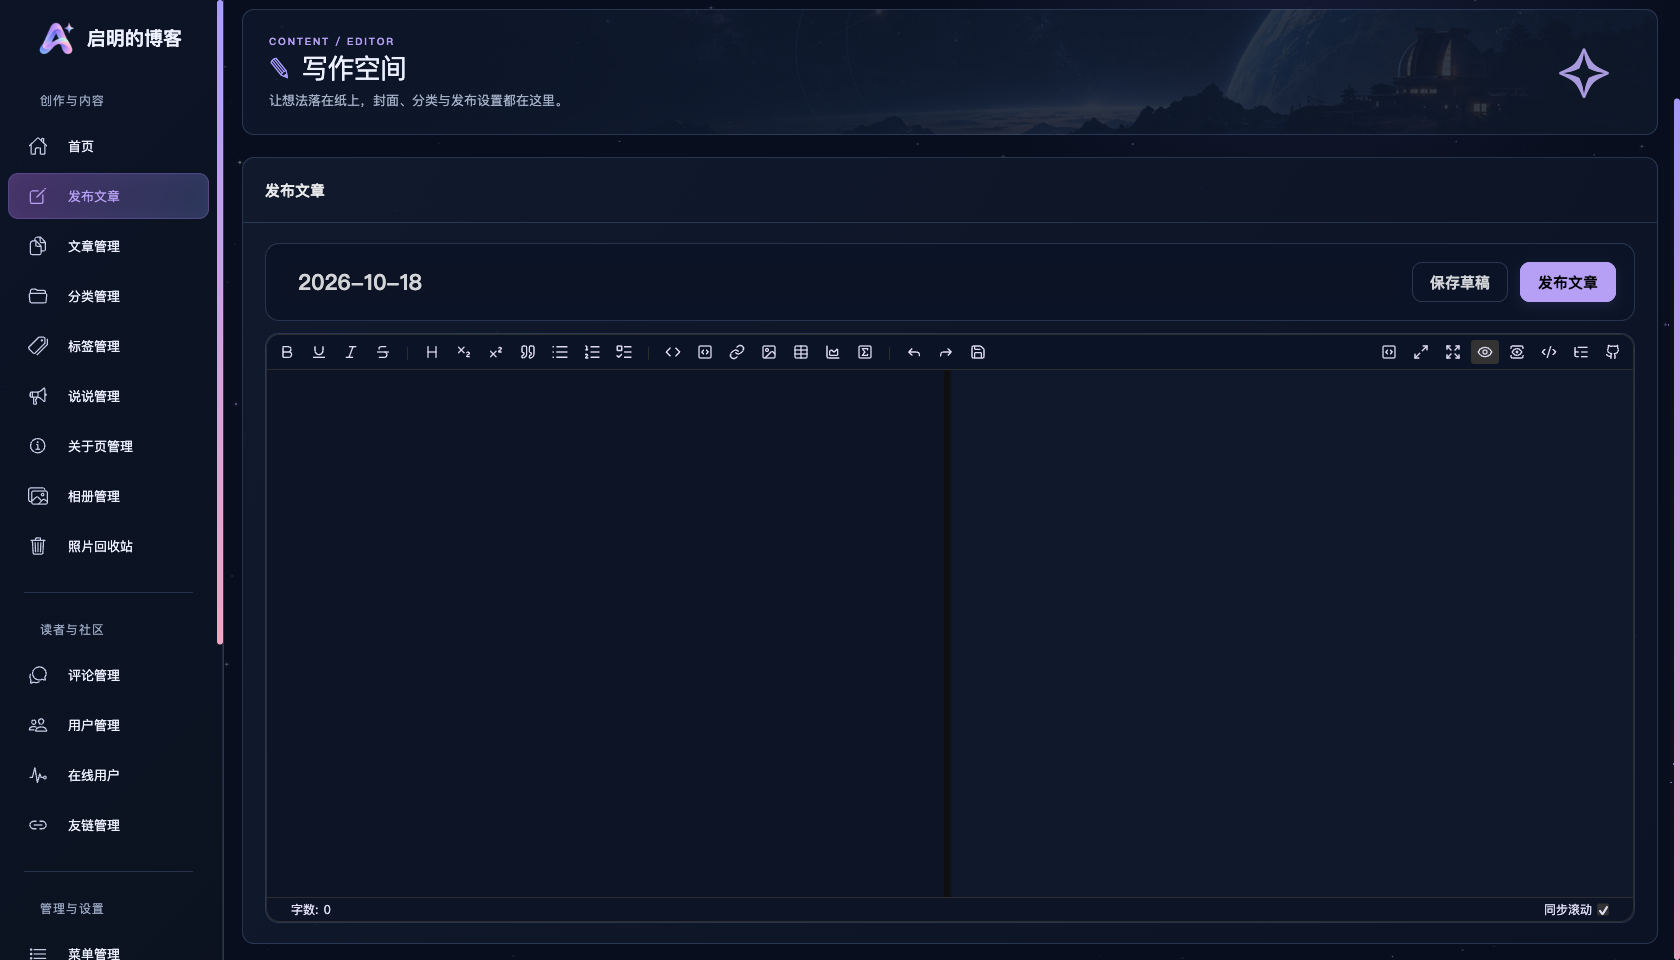
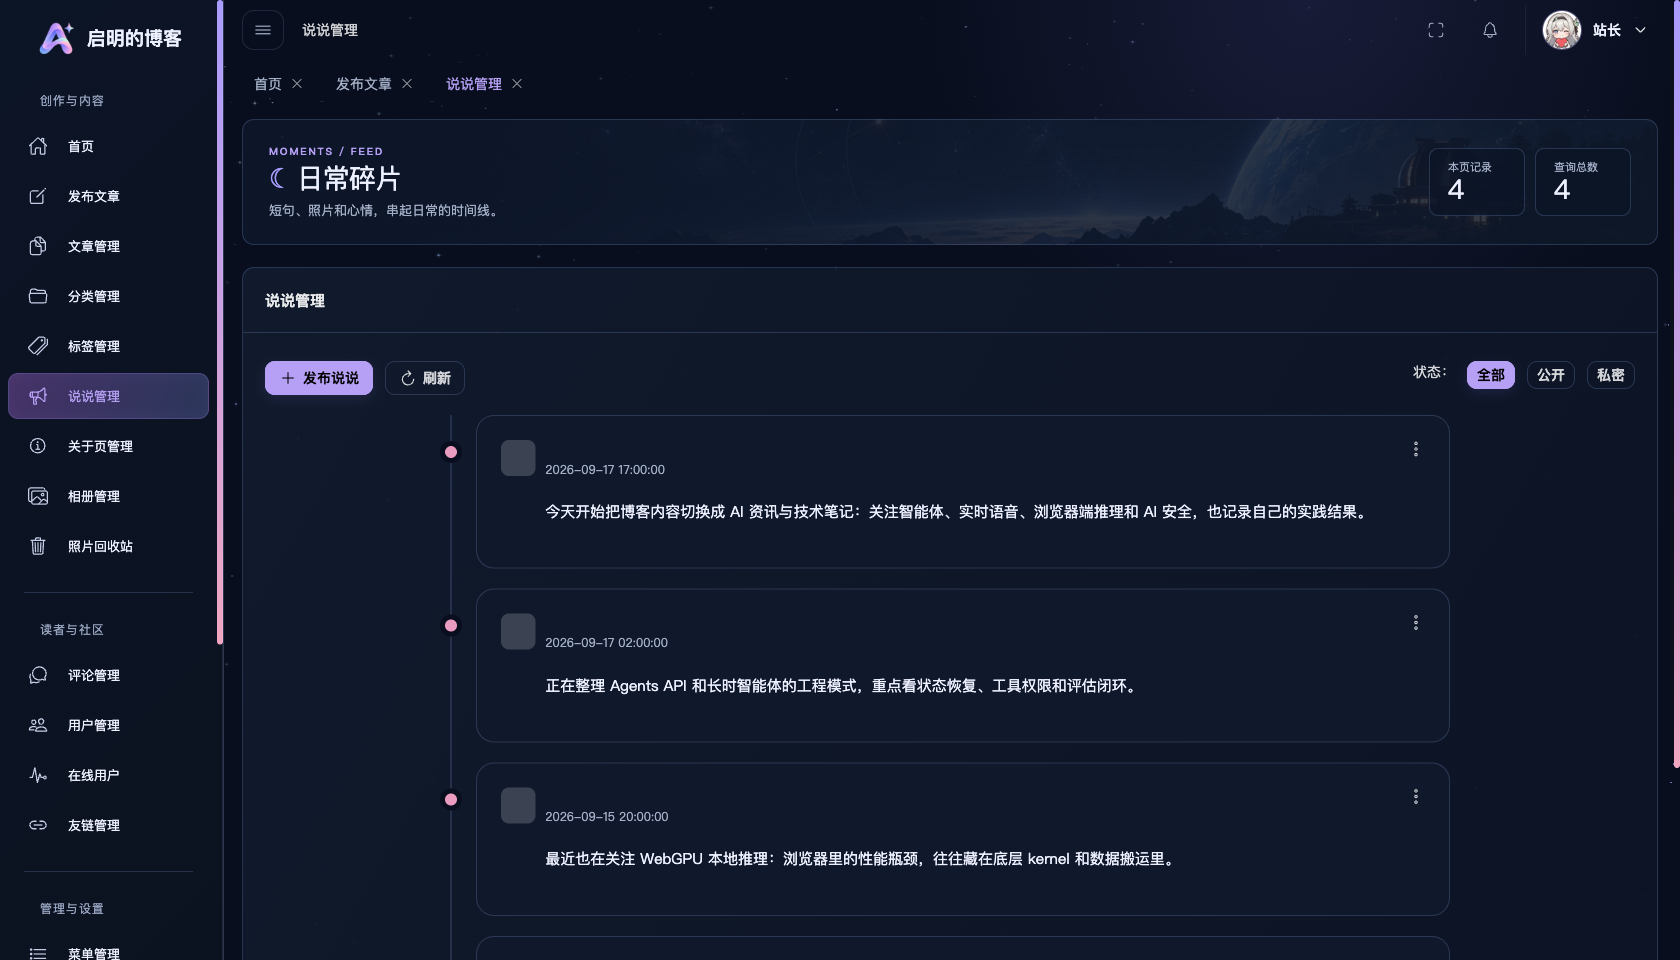
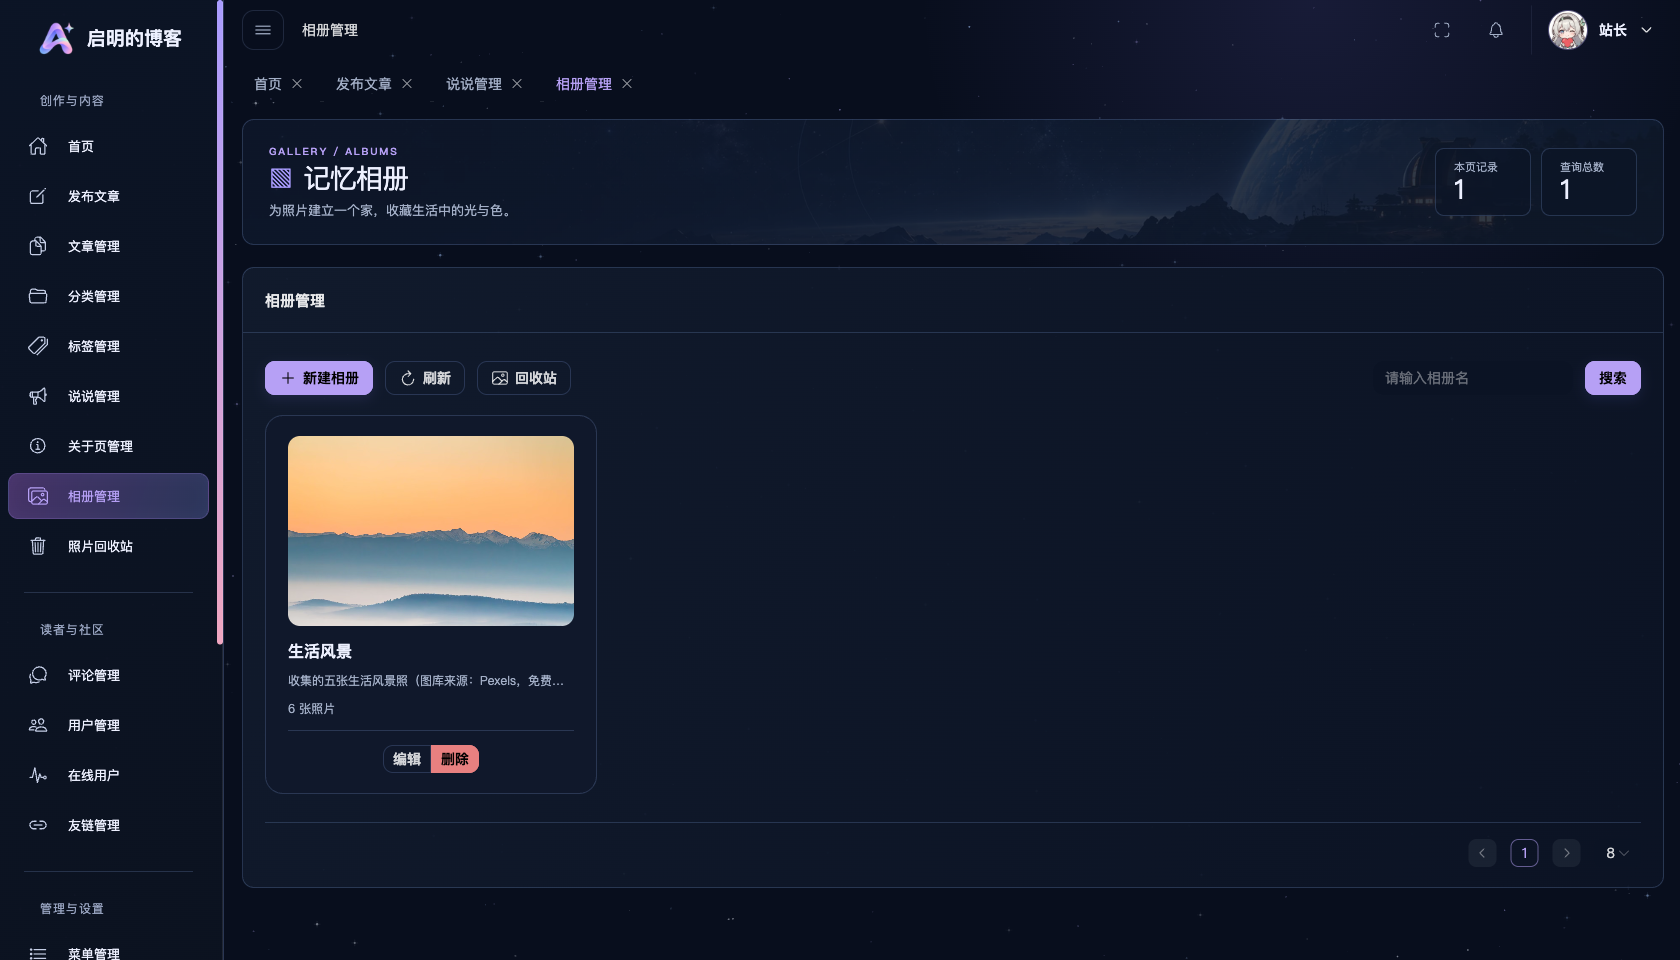
真数据真读写的主体:仪表盘(含观星台)、文章发布/管理、说说、相册、照片回收站、分类、标签、友链、评论管理、用户管理、在线用户、操作日志、个人中心(头像/昵称/改密)、登录。
- 文章:md-editor-v3 富编辑器,封面、分类标签、草稿/发布/加密三种状态;中文标题自动转拼音 slug;删除进
_quarantine/隔离区而不是物理删除;构建期 AES-256-GCM 加密的文章拒绝在线编辑——盲目改写会让原密码失效,这条拦截救过我一次。 - 说说:前台”动态”页的数据源,发布时文件名用 Asia/Shanghai 时间戳,和主题约定完全一致。
- 相册:数据 JSON 化(
gallery.json),照片批量上传进public/gallery/<id>/,删错了有回收站可恢复。 - 分类/标签:有个设计细节——列表是”文章 frontmatter 派生 ∪ 预注册表”。预注册表是张 SQLite 小表:后台新添加一个还没被任何文章用过的标签,发文编辑器里立刻可选,而不是等第一篇文章用了它才凭空出现。重命名则是批量改所有引用文章的 frontmatter,真实生效。
- 友链:写
friends.json,前后台同一份数据,保存后前台重建即可见。 - 操作日志:所有写操作、登录成败(包括失败原因:账密错/验证码错/限流)、CSRF 拒绝全部落审计表,可查可清空(清空动作本身也留痕)。
能看能存但没接全的:网站配置、关于页编辑——数据存进了 SQLite 的运行时 JSON,但不驱动前台构建,前台关于页仍是仓库里的 about.md。这是有意的分期:先把数据通道打通,构建联动放后续。
如实占位的:角色管理(轻量模型,固定 admin/user 两个角色,不可在线编辑)、菜单管理(固定树)、接口权限、定时任务、异常日志。页面在、UI 在、后端老老实实返回空数据和提示文案,不装样子。
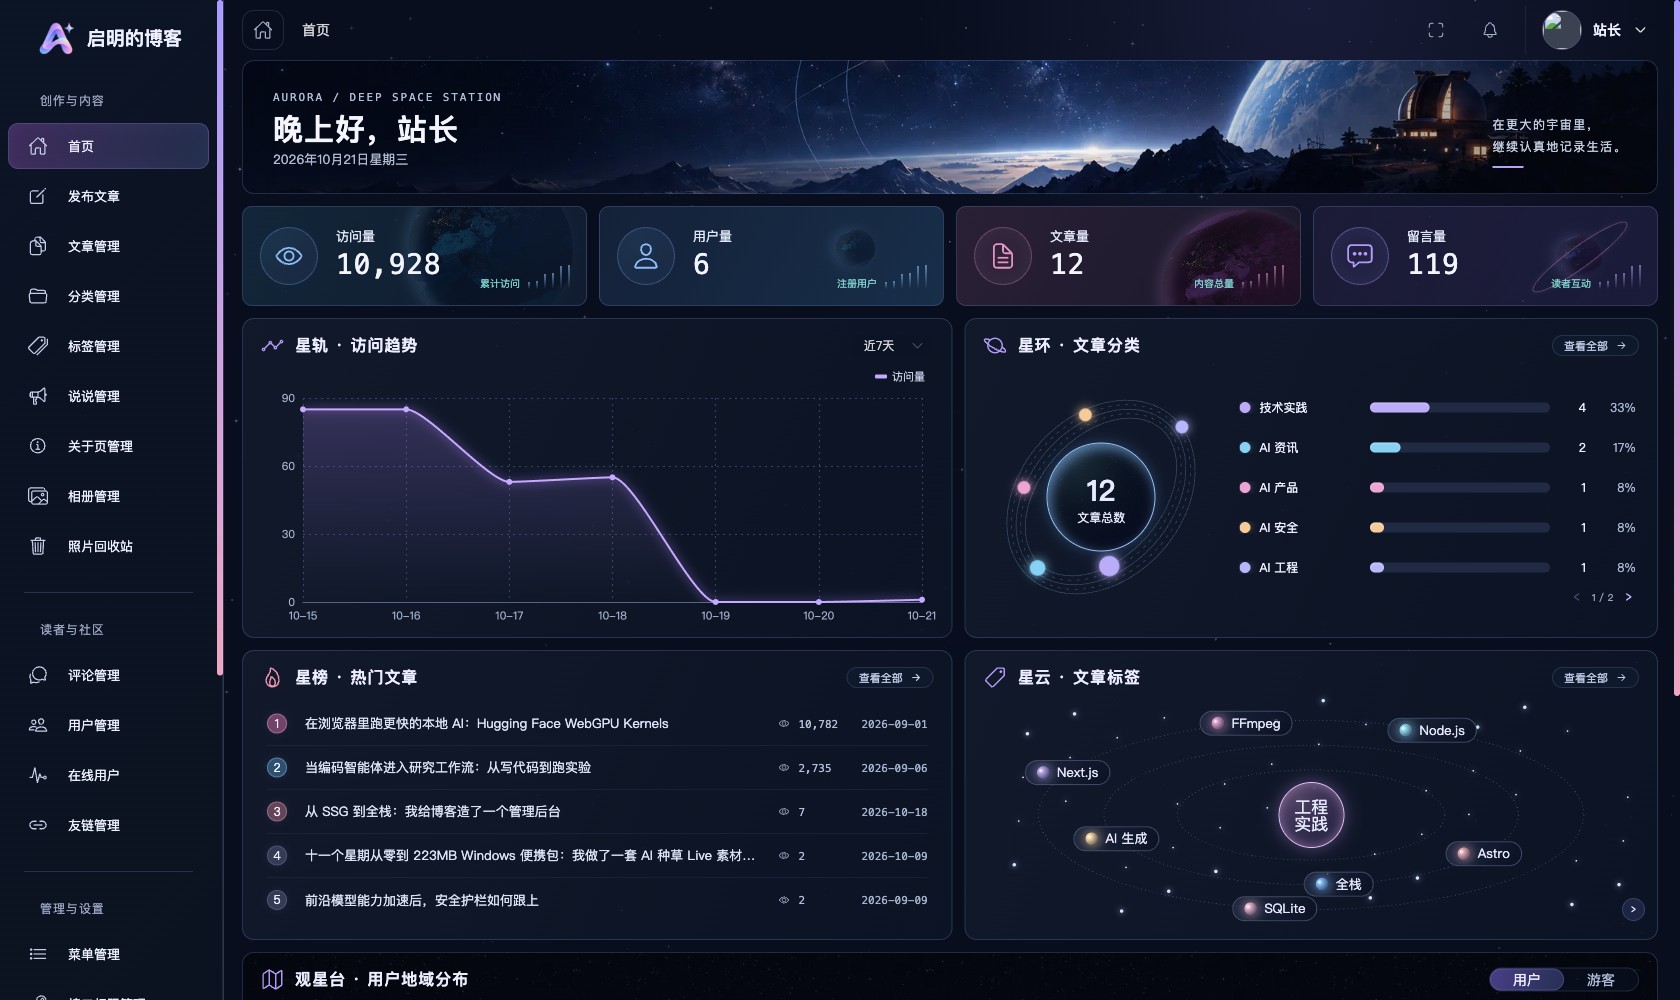
服务端是 Hono(轻量 Web 框架)跑在 Node 24 上,中间做了一层协议适配层:前端按一套 {flag, code, message, data} 包络的 REST 契约通信,适配层负责把请求翻译成对 Markdown 文件树 / SQLite / Artalk 的具体操作,用 hashId 做稳定数字寻址,Bearer token 鉴权。这层抽象的价值在于:前端页面和存储实现完全解耦,后面无论换存储还是加缓存,页面一行不用动。
三、评论系统:前台 Artalk,后台”读者来信”
评论是博客的灵魂,也是这套系统里对接最”缝缝补补”的部分——因为评论系统是独立的自托管 Artalk(Go 单二进制,数据在自己的 artalk.db),和管理后台是两套进程、两套用户表。我的原则是:Artalk 保持独立运转,管理台做它的”遥控器”。
前台评论区:Artalk 2.10 自托管,前端 UI 也自托管在自己域名下(不依赖 CDN),OpenResty 同源反代,零跨域。访客三种参与姿势:
- 游客直评:填个昵称和邮箱就能发,零门槛;
- 跳过验证:Artalk auth 插件的弹窗里有个”跳过验证”选项,本质和游客一样,但身份会记住,下次来不用重填;
- 邮箱验证注册:邮箱收验证码,注册成正式评论用户,能收到被回复的邮件通知。
管理台的评论管理页叫”读者来信”,对接方式比较Hack但每一步都有理由:
- 读列表不走 API,直读它的 SQLite。Artalk 的公开评论接口强制要求 page_key(按页面查),管理台要的是全站列表,API 拿不到。好在 artalk.db 就在同一台服务器上,
node:sqlite只读打开,一条 JOIN 把评论、昵称、邮箱、父评论全部拿出来,零认证零开销。评论者的昵称邮箱在 users 表里,SQL 里 JOIN 一下就好。 - 写操作全部走它的 HTTP API。改状态、置顶、删除、回复,都是对 Artalk
POST/PUT/DELETE /api/v2/comments的翻译。回复评论时用机器人管理员账号(firefly-admin)发子评论——评论者在前台看到的就是站长本人回复的,身份统一。 - 状态语义做了一层映射:Artalk 的
is_collapsed映射成”垃圾”、is_pending映射成”待审”、默认”通过”;is_pinned是置顶。管理台一键切换,后台翻译成对 Artalk 字段的修改。 - 邮件通知有个总开关:新评论会给管理员发邮件,有时嫌吵。做成了评论管理页角落里的一个开关——读 Artalk 用户表的
receive_email字段,切换时把管理台账号邮箱名下的所有 Artalk 用户一起切了,一次点击全局生效。
这套对接里最阴的坑:Artalk 的 PUT /api/v2/comments/:id 是全量替换语义——你只想改一个”置顶”字段,就得把正文、昵称、邮箱、页面、站点等十来个字段全部带齐,漏一个它就给你清成空。适配层的做法是先从库里读全量、合并变更、再整包提交。这个坑官方文档里写得极隐晦,是拿 400 报错一次次试出来的。
四、用户体系:谁能干什么
这套系统里其实住着五类”人”,各管各的:
| 用户 | 住在哪 | 能干什么 |
|---|---|---|
| 游客评论者 | Artalk | 填昵称邮箱直评,不用注册 |
| 注册评论用户 | Artalk | 游客的一切 + 邮件接收回复通知 |
| Artalk 管理员 | Artalk | Artalk 自带后台删评论(兜底用) |
| 博客管理员(我) | admin.db | 后台的一切:内容、评论、用户、配置、发布 |
机器人 firefly-admin | 两边都是管理员 | 管理台所有评论写操作的技术身份 |
博客管理员只有我一个,但防它被偷的工夫下得最足:
- 密码:scrypt 加盐哈希,16 字节盐、64 字节派生键、恒时比较,库里不存明文。
- 登录是双因子:账号密码 + 邮箱验证码。验证码只在账密验证通过后才发(错密码不发码,不给人刷邮件的机会),经 SMTP 发到站长邮箱,10 分钟有效、60 秒限频。会话 7 天有效落库,设备、IP、UA 都记着。
- 会话可踢:在线用户页能看到所有活跃会话(哪个浏览器、最近什么时候、什么 IP),看不对劲一键强制下线。
- 老协议登录还有失败锁定:IP + 账号 15 分钟窗口内错 10 次直接锁。
- CSRF 双提交校验、跨域白名单只放行自己的域名。
- 所有动作留痕:审计日志覆盖全部写操作,谁在什么时间改了什么、结果如何,查到底。
角色模型很轻:admin / user / banned 三档,user 可以在后台被禁用或提权。没有做细粒度 RBAC——单人博客,一个管理员,权限模型的复杂度不值得。这是”没做好的”清单里的一条,后面细说。
五、观星台:自建访客统计
第三方统计(GA、Umami 云版)要么慢要么要往别人服务器送数据,我选择完全自建,链路五步:
- 埋点:前台每个页面内联一段脚本,加载时
fetch + keepalive上报一条{path, title},跳页不丢。 - 接收:Hono 接口从
X-Forwarded-For取真实 IP,每 IP 每分钟限流 60 次。 - 地域解析:用 ip2region 离线 xdb 库(随 npm 包分发,约 11MB)在服务器本地查 IP 归属地,输出到城市级(“江苏·无锡”),外国 IP 输出国家。不联网、不调第三方 API、不泄露访客数据。
- 去重落库:
md5(IP|User-Agent)做当日指纹,首次出现记 1 个 UV,地域计数只对新指纹累加——反复刷新不灌水。数据库里不存明文 IP,只有指纹和归属地。 - 可视化:仪表盘聚合出趋势、分类、热门、标签云;地域分布就是观星台。
观星台是仪表盘里的整幅面板,三件套:3D 地球仪(echarts + echarts-gl 渲染,夜景贴图上用 canvas 现场烘焙国界和中国省界,访客光点按热度分三档大小,Top1 到 Top6 之间画飞线,自动旋转、可拖拽缩放)、点阵中国地图(SVG 手绘省界,省份按访客量打点阵)、地域排行条(Top8 占比)。三块共享同一份省份质心坐标表,地名归一化后匹配不到城市的自动落到省质心,一个访客都不会丢。
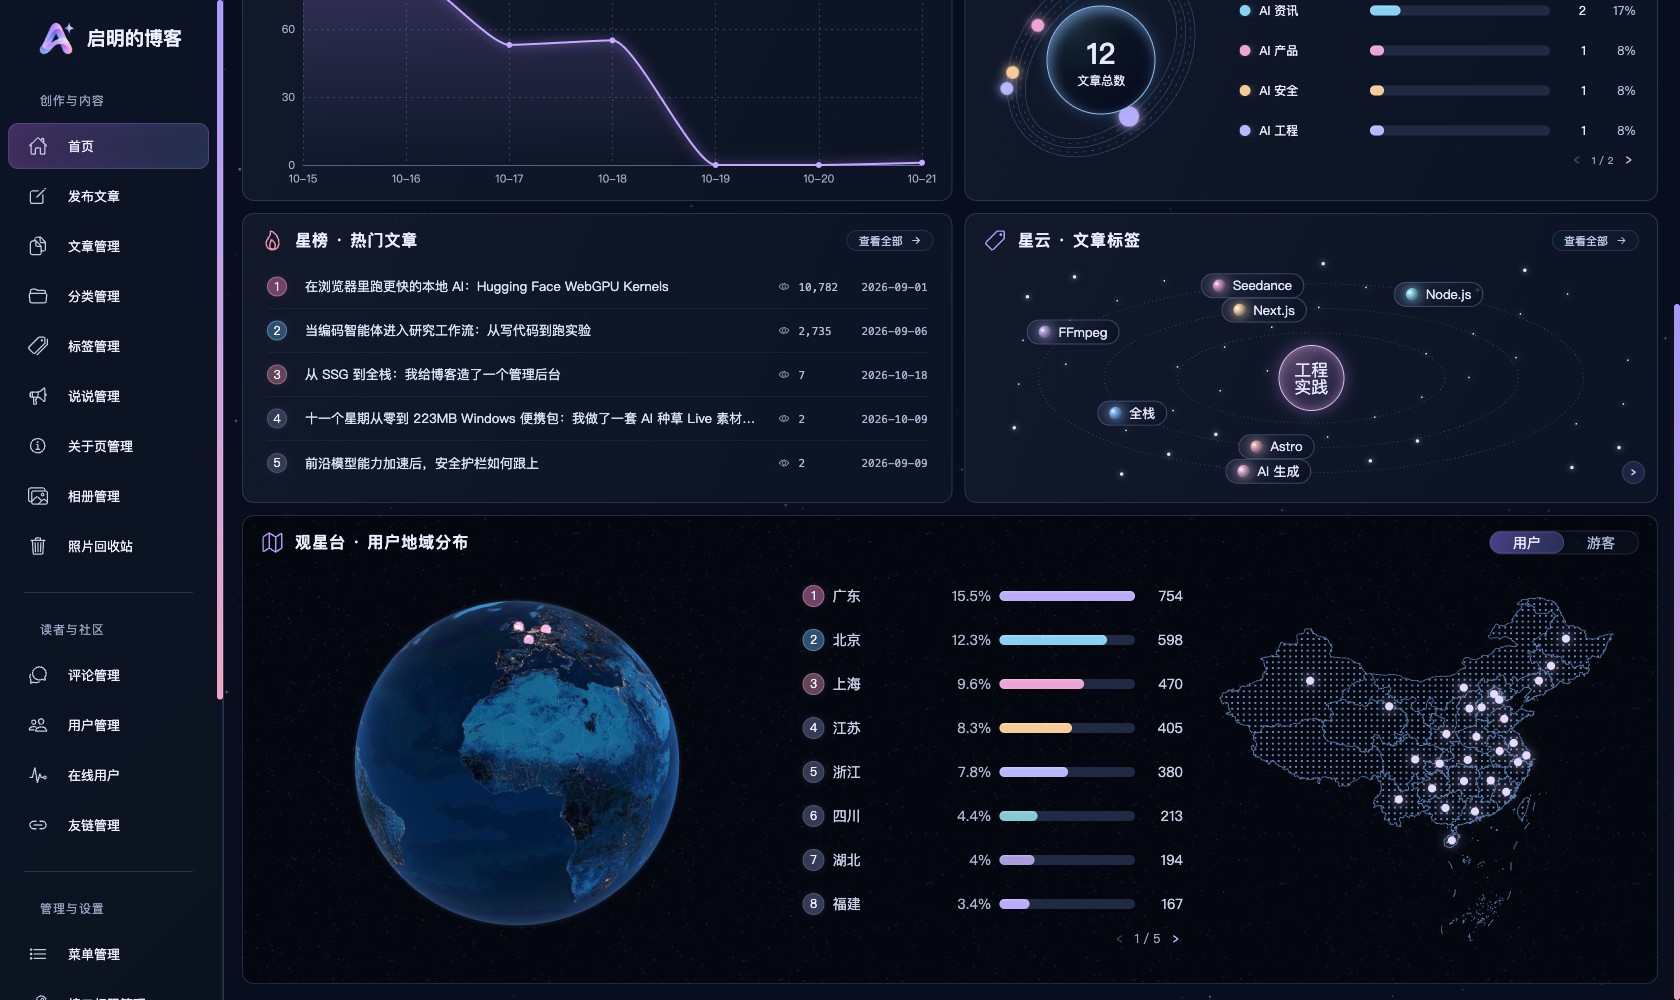
实际跑起来很有意思:上线当晚观星台就冒出一个”美国”访客,拿 nginx 日志反查,是 Googlebot——它用内置 Chromium 渲染页面执行了埋点脚本,被如实统计了。顺带等于免费的搜索引擎收录监控,百度蜘蛛、Google 的爬虫什么时候来、爬了哪些页,一目了然。
坦白一个仪表盘上的小把戏:四张统计卡里的”留言量”,取的其实是审计日志的行数——aurora 协议里有这个字段,而审计日志的增长确实和站点活跃度正相关,就拿它顶了。等评论管理完全成熟后换成真实评论数。
六、热门文章:一个 SQL 的事
前台侧栏的”热门文章”是这套统计的赠品,实现干净得近乎偷懒:
埋点落库的 page_views 表本来就按”日期 + 路径”记浏览量。侧栏组件在构建期直接用 node:sqlite 只读打开 admin.db,执行 SELECT path, SUM(views) FROM page_views WHERE path LIKE '/posts/%' GROUP BY path ORDER BY SUM(views) DESC,和文章集合 JOIN 出标题,渲染成一个静态 <ol>——零客户端 JS,零额外接口。观星台的”星榜”和它是同一张表的两个视图。
它成立的前提很有意思:构建发生在服务器上,数据库就在同级目录。SSG 的构建期能读生产库,这件事本身就是”博客和管理后台住在同一台机器上”的红利。代价是热门排序只随发布刷新——每天的发文明明会触发重建,所以实际上它每天都在更新,够用了。
七、发布管线:写完即上线
这是整个系统最提气的一环。18 处写操作(发文、改文、发说说、传照片、改友链、动分类标签……)落库/落盘后自动触发构建发布:
- 单飞 + 排队合并:构建有互斥锁,构建中来的新写操作进队列,结束后合并触发一次——连发三篇文章也只构建一轮。
- 完整 8 步构建链:
astro build之后接资源裁剪(砍掉未启用的看板娘模型,省 9MB)、字体子集化、内联脚本压缩(省 1.1MB)、PageFind 搜索索引生成,一步不省。 - 原子交换上线:新产物构建到暂存目录,
mv原子交换,失败不触碰线上目录;上传的图片双写(站点目录 + 源码public/),重建不丢。
从点”发布”到前台可见约 40 秒,全程 systemd 托管,日志落盘可查。
八、踩坑实录
1. better-sqlite3 在 Node 24 上的 GC 崩溃
一开始用 better-sqlite3,某个版本起在 Node 24 上随机 Abort trap 6——Statement 对象被 GC 回收时触发原生断言,进程直接死,日志里一点预兆没有。排查后换成 Node 内置的 node:sqlite(DatabaseSync),零原生依赖,问题消失。记一笔:新 Node 上原生 SQLite 绑定的成熟度远不如官方内置实现。副作用是内置 API 更朴素——没有 db.transaction(),要自己写 BEGIN/COMMIT,参数绑定对中文 WHERE 还有怪癖(用 HEX(col) 比对绕过)。
2. 批量删除删了 0 条也报”成功”
管理台的批量删除曾整体静默失效。抓包发现前端 axios 把 id 数组当作裸 JSON body 发出去,而服务端只在 body.idList / body.ids / body.id 里找——找不到就删 0 条,然后照常返回成功。修法是服务端加了个 idListOf() 兼容函数,裸数组、idList、ids、id 四种形态都认。教训:“删除成功”的响应必须拿真实删除数说话。
3. 标签”添加成功”是假的
前端硬编码弹”添加成功”,后端却根本没有标签落库逻辑——列表由文章派生,加进去的名字没人记,刷新就消失。修法是上一节说的 taxonomies 预注册表,让”添加”变成一个真实的 INSERT。假成功比失败危险,失败至少逼你去看。
4. Artalk 的 PUT 是全量替换
第三节说过的坑,单独列一条是因为它差点把一批评论的元数据清空。任何”改一个字段”的 API 调用都必须先读全量、合并、整包提交。Artalk 文档没写,靠 400 报错试出来的。
5. .mjs 的 MIME 之坑
Artalk 前端某些资源是 .mjs 后缀,OpenResty 的 mime.types 不认它,返回的 Content-Type 不对,浏览器静默拒绝执行 ES 模块——评论区整块空白,控制台一声不吭。修法土但有效:全部存成 .js。
6. frontmatter 日期必须传 Date 对象
gray-matter 序列化时,字符串日期会变成带引号的 '2026-10-18',而博客 schema 用 z.date() 要的是无引号日期字面量——一字之差,dev 直接炸。从此约定:所有写 frontmatter 的代码一律传 new Date()。
7. 发布管线的两起”无声事故”
一起是 Astro 7 的内容缓存:项目根的 .astro/ 缓存了内容集合索引,删除文章文件不会让增量构建感知——线上删文,前台照样能访问。修法是发布脚本里先 rm -rf .astro 再构建。
另一起更隐蔽:某次用 root 身份手动跑了一次构建,root 重建的缓存目录让后续 ubuntu 身份的发布脚本死在第一步,而错误只进 stderr、构建日志里只留下一句 “build start”,彻底无声。修法是给发布脚本加 trap ERR 失败即写日志,并且立下铁律:服务器上一切构建只以服务账号身份跑发布脚本,永远不手动 sudo 构建。
九、部署与性能
- OpenResty:静态优先 + 命名反代兜底;带内容哈希的资源
immutable一年缓存;预压缩 gzip_static,压缩在构建期完成,请求期零 CPU。 - Node 24 绿色版 + systemd:Admin Server 独立服务,开机自启、崩溃拉起。
- 构建期字体缓存:字体 CDN 不通的场景下用本地缓存目录喂给 Astro,构建不因外网抖动挂掉。
- 大图治理:登录页和观星台背景原图各约 2MB,小水管服务器要加载 8 秒;转 webp 后 100KB 级,JS 走构建期预压缩。
十、Live2D 看板娘
前台还有一个可切换宠物、可对话的 Live2D 看板娘(pixi.js 运行时 + 多模型按需加载 + 对话走自建 AI 代理),构建链里的资源裁剪就是为它服务的——把没启用的模型从产物里裁掉,启用即回归。模型贴图做过调色板压缩(5.5MB 的模型贴图压到 335KB),配套的缓存策略要求贴图内容变了必须换文件名,否则 CDN 拿旧图。
十一、反思与后续
做对了的:Markdown 文件做事实源(后台可抛弃、仓库永留存);协议适配层隔离了前端和存储;自建统计把访客数据 100% 留在自己服务器;发布管线的原子交换和单飞合并在最忙的时候也没掉过链子。
没做好的:网站配置和关于页存了运行时 JSON 但没接进构建(前后台两套数据源);角色管理是只读占位,没有细粒度权限;异常日志恒空、定时任务是空壳;部分老接口会话过期时返回 500 而不是 401,前端只能笼统报错;评论管理直读 SQLite 的前提是”同一台机器”,哪天 Artalk 搬家就要改成走 API。
后续:网站配置驱动前台构建、评论数据全量走 API 化、异常日志接进程级捕获、给发布管线加一个”一键回滚到上一版产物”。
写在最后
这套系统的意义不止是”有了个后台”:它把一个纯静态博客升级成了单人可运营的全栈内容平台——写作、评论、统计、发布、监控在一个浏览器标签页里闭环,同时前台保持 SSG 的极致性能,数据 100% 留在自己服务器上。
技术栈总览:Astro 7 / Hono / node
如果只让我挑三个最值得聊的点:协议适配层带来的解耦、单飞合并的发布管线、还有不依赖任何第三方的访客统计——它们分别回答了”怎么设计扩展点""怎么处理并发写""怎么在隐私和洞察之间取平衡”。踩坑实录里那七条,则是替未来踩过这些坑的人提前交的学费。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!