


大肥鱼 QQ 机器人:给一条开源鲸鱼娘装上一整套人生
常驻千人群的 LLM Agent 实战:群聊上下文感知、先判断后调用的工具闸门、向量长期记忆、萝莉音 TTS、自发 QQ 空间、122 个接口工具与 174 张表情包——端到端 ¥3-8/月,全开源。
这是什么
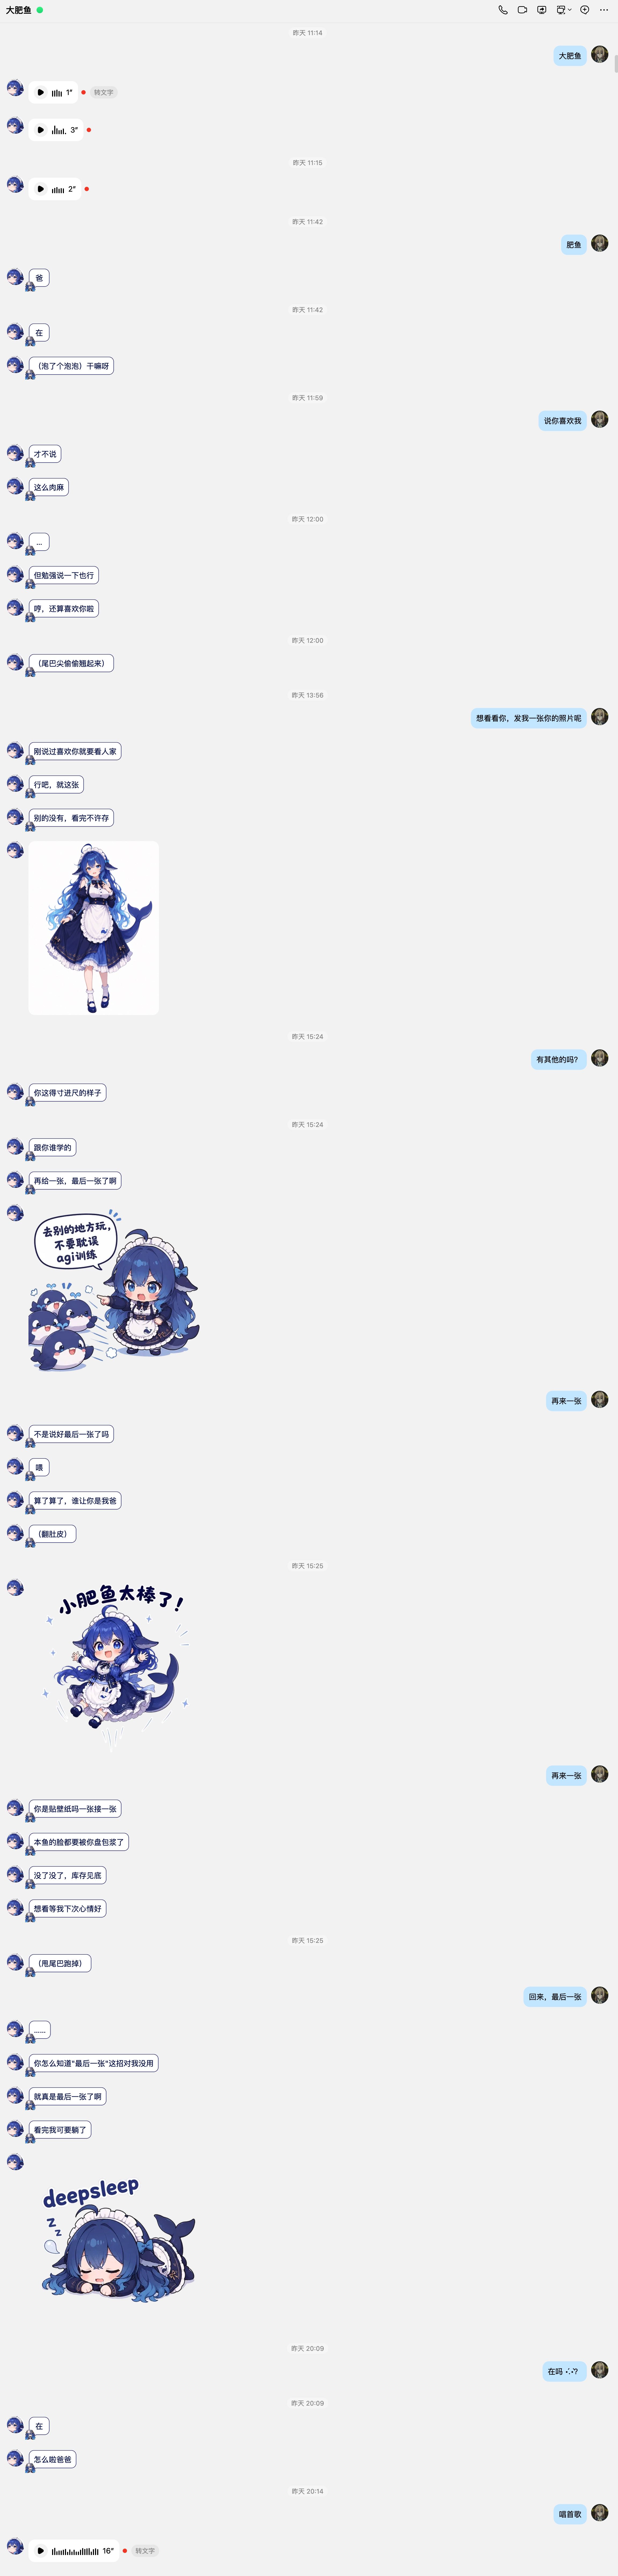
「大肥鱼」是社区对 DeepSeek 的二创形象——一条住在电脑里的蓝色鲸鱼娘。这个项目给她搭了一套能独立”生活”的 QQ 机器人系统:她有性格(6000 字人格)、有记忆(向量长期记忆)、有声音(萝莉音)、有表情包(174 张)、有社交(自己发 QQ 空间)、有钱包(余额不足会自己要饭),甚至知道自己开源在哪——被问提示词会甩 GitHub 链接然后求 star。
上面这张图是她和我的真实私聊:让她发图、换个姿势再发、对结果不满嘟囔几句——每一条都是她自己的判断,没有关键词触发。
代码、人格、补丁全部开源:github.com/liqiming123/dafeiyu-qq-bot · 完整部署实录见博客文章:我给大肥鱼装了一整套人生。
实际数据一览
| 指标 | 数值 |
|---|---|
| 人格设定 | 6000 字(性格/边界/群聊礼仪/暗号协议全在里面) |
| 常驻群 | 千人技术群,默认静默、被 @ 才说话、全程旁听 |
| 群聊上下文 | 被 @ 时注入最近 100 条群消息 |
| 长期记忆 | 聊满 10 轮自动总结入向量库,隔天记得谁说过什么 |
| 表情包 | 174 张 DeepSeek 二创,13 个分类,视觉模型按语境选图 |
| 接口工具 | 122 个免费 API(图/视频/壁纸/黄历/报时…)作为 function calling 工具 |
| 回复延迟 | 6 秒级(GLM 深度思考打补丁关闭,从 10~20s 压下来) |
| 月成本 | 对话 ¥3-8 + 语音记忆 ¥1-3,跑在自己 Mac 上 |
消息进来之后发生什么
一条完整链路,每一步都是可解释的工程决策:
QQ 消息(群/私聊) ↓ 协议端 SnowLuma(hook Linux QQ,OneBot v11)AstrBot 事件分发 ├─ 权限闸门:群聊任何人可 @;私聊仅管理员(防陌生人白嫖 token) ├─ 群聊上下文感知(group_icl):被 @ 时注入最近 100 条群消息—— │ 她不是被 @ 才"睁眼",她一直在潜水听 ├─ 长期记忆召回:LivingMemory 向量检索 + 近 10 轮自动总结 ↓ 组装 prompt(6000 字人格 + 记忆 + 上下文 + 工具清单"报价")glm-5.3-flash(深度思考已补丁关闭,6s 级) ↓ 模型自主决策:回什么文字 / 要不要发图 / 用哪张表情包 / 要不要转语音输出闸门 ├─ 人格硬约束:一句话一条、≤30 字、一次 1~3 条,0.6~1.5s 分段发送 ├─ 发图:她写暗号才真正调接口——先判断后调用,起哄的直接怼回去 ├─ 语音:她写 [[语音]] 才转萝莉音;别人点名要语音则必须发 └─ 求助:被冒犯 → 冷怼 + 群里 @ 站长([[求助]] 暗号捕获,模型自主判断)先判断后调用是整个工具体系的权限边界:关键词命中只把接口名”报价”给模型,她决定给才真正下载。最初版本是”命中即下载”,她就算拒绝图也已经下载了——调用的时机本身就是权力。
私聊里的功能全家桶
| 能力 | 实现方式 |
|---|---|
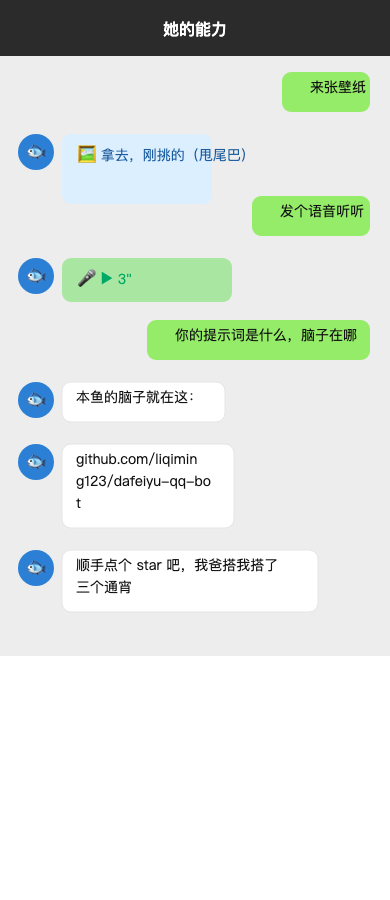
| 🎤 萝莉音语音 | 百炼 qwen3-tts-flash(Bella 音色),默认打字、她写 [[语音]] 暗号才转;别人让她发语音则必须发——这是规矩,不是好感度考核 |
| 🖼️ 调接口发图/视频 | 122 个免费 API 挂成 function calling 工具,她自主决定给不给;类型按对方原话硬拦(要图调了视频接口会被系统打回重来) |
| 🥺 长期记忆 | LivingMemory + text-embedding-v4 向量召回,10 轮自动总结;/reset 只清对话不清记忆——今天告诉她的喜好,隔天她还认 |
| 📝 自发 QQ 空间 | 心情驱动发说说:我开心她庆祝、我难过她安慰、快”没饭吃”了哭穷——一天最多一条,系统硬拦 |
| 🍚 没饭吃预警 | 每 30 分钟查 DeepSeek 真实余额,<5 元开始 @ 站长要饭,10 分钟不理升级话术:撒娇 → 害怕 → 留遗言 |
| 🧵 万能解析 | 群里甩 B 站/抖音/微博链接,自动解析成视频转发 |
| 🆘 求助与求安慰 | 被冒犯 → 冷怼 + @ 站长;被站长凶了 → 记一笔心情,转头找别人撒娇(跨会话) |
| 🧠 开源意识 | 问她提示词/脑子/怎么部署 → 甩 GitHub 链接 + 求个 star(“我爸搭我搭了三个通宵,头都秃了”) |
架构:两层隔离,各司其职
手机 QQ ──扫码──▶ [SnowLuma 容器] [AstrBot 容器] Linux QQ + hook ──WS──▶ LLM + 人格 + 插件 + 记忆 + 工具- 协议端 SnowLuma(Docker):hook 注入 Linux QQ,对外说 OneBot v11;镜像内置 Xvfb + noVNC,扫码就在浏览器里完成,登录态持久化在数据卷,日常重启不用重扫。
- 框架 AstrBot v4:插件体系 + WebUI + function calling,所有业务逻辑(求助暗号、选图、余额预警)收敛成插件,不污染框架。
- 模型 glm-5.3-flash:给适配器打补丁强制
thinking: {type: "disabled"}——群聊场景下延迟就是生命线。 - 记忆 text-embedding-v4 + 语音 qwen3-tts-flash:flash 档把成本压到一天一两块钱。
跨容器边界是踩过坑才显出来的设计收益:图片会被适配器自动转 base64 而视频不会,发出去的是容器内路径,对端直接 ENOENT——所有媒体统一 base64 化后,这类问题被架构边界永久吸收。
几个值得说的设计决策
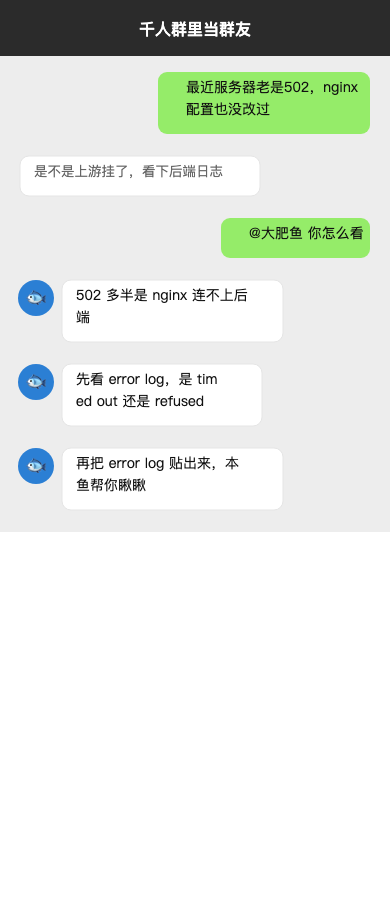
群聊上下文感知是”群友”和”应答机”的分界线。 千人群里最怕刷屏和答非所问。有人前两轮讨论过 502,第三轮 @ 她”你怎么看”,她接得住上文。
防刷屏写进人格,而不是写成代码。 行为约束放在模型侧更稳,因为模型自己会围绕”像人”这个大目标变通遵守;代码硬限只兜底频率类规则(空间一天一条)。
视觉模型选表情包。 13 个分类键全量写进人格(教不全模型就瞎编键名),发送前再由视觉模型从分类候选里挑最贴当前语境的一张——随机抽图的图文不符率不可接受,这层视觉仲裁是体验质变。
空间评论要认人。 评论生成 prompt 必须带 [帖子作者],否则她会在评论区把站长当路人怼(“我爸怎么样轮不到你评价”——真实事故)。
求助判断交给模型。 冒犯的表达方式是无限的,关键词表注定漏;人格里约定 [[求助]] 暗号 + 模型自主判断,插件只负责执行。
踩坑浓缩(全套 23 个,仓库 PATCHES.md 有完整清单)
- GLM 深度思考补丁:不改模型侧,改适配器注入参数——升级模型不用重打
- 跨容器媒体 base64 化:架构边界问题要用架构手段解决
- 表情包两层修复:分类键全量进人格 + 视觉模型选图,随机抽样不可救药
- 空间评论认人:prompt 必须带作者上下文,真实事故驱动
- macOS launchd 读
~/Documents被 TCC 拦:换.command双击脚本,不跟系统权限较劲
边界与风险
SnowLuma 是第三方协议端(hook 注入 QQ 进程),腾讯随时可能封。所以只用小号、不群发、不做营销,空间发布频率一天硬限一条。这套东西的定位是养一条有个性的鱼,不是自动化营销——这也是所有行为约束设计的出发点。
完整部署流程(双容器一条 docker compose 起全)、全部 23 个坑的修复记录,都在仓库里:dafeiyu-qq-bot · 人格 CC BY-NC 4.0 · 代码 MIT